
Что означает «Страница просканирована, но пока не проиндексирована»
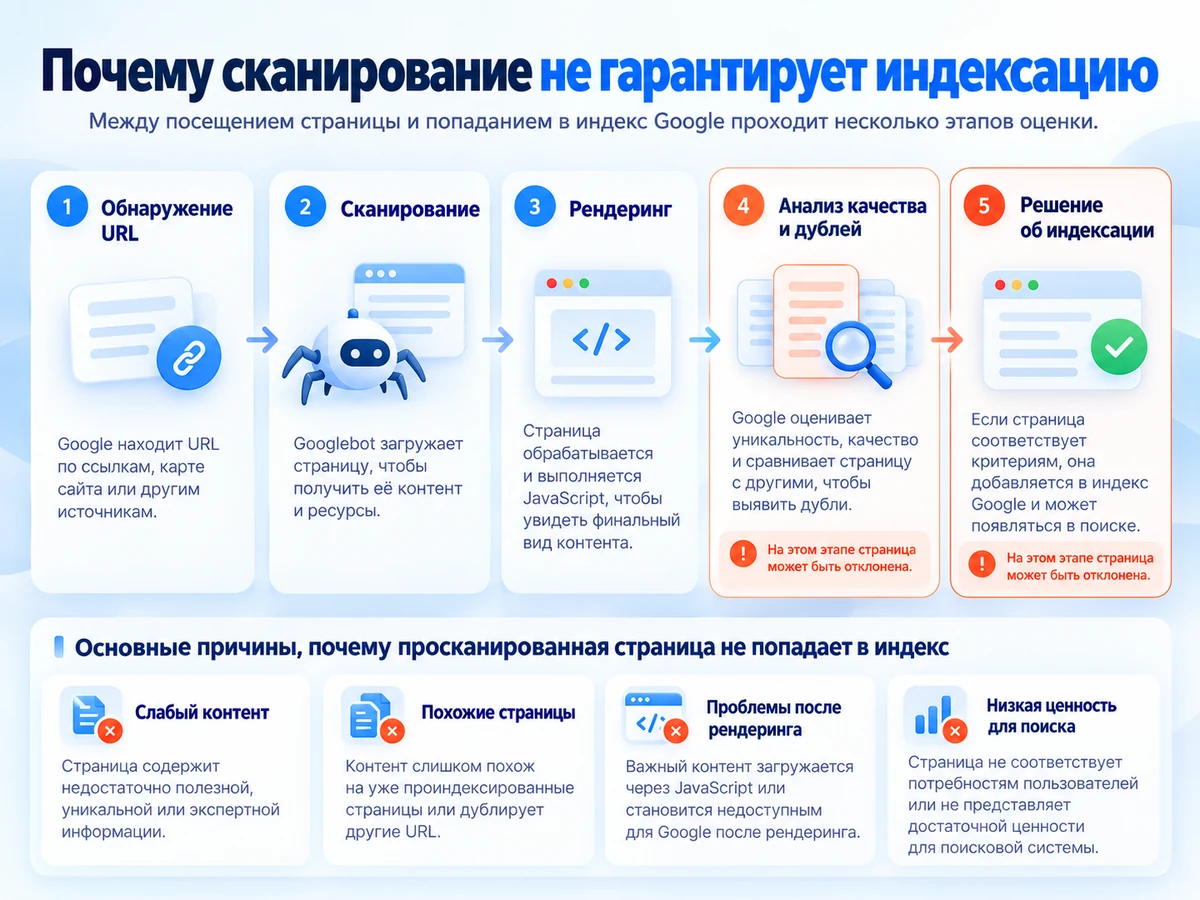
Google проходит несколько этапов: обнаружение URL → сканирование → обработка и рендеринг → решение об индексировании. Успешное сканирование не равно индексации. Поисковик может получить HTML, но не включить страницу в свой индекс сейчас или вообще не выбрать ее для индексирования.
В отчете Google Search Console такой URL попадает в раздел «Не проиндексировано». При этом само сообщение не раскрывает точную причину. Оно не означает автоматически, что Google наложил санкции, на странице есть ошибка кода или ей не хватает заданного количества слов.
Также не нужно добиваться индексации всех URL подряд. Параметры сортировки, технические варианты карточек, страницы фильтров без отдельного спроса и дубли могут совершенно нормально не попадать в индекс. Ключевой вопрос - не проиндексирована ли действительно важная посадочная страница.
Чем отличается от статуса «Обнаружена, не проиндексирована»
| Статус | Что произошло | С чего начинать |
|---|---|---|
| Обнаружена, не проиндексирована | Google знает URL, но, по данным отчета, еще не просканировал страницу. | Доступность сервера, навигация, Sitemap, объем и приоритет обхода. |
| Просканирована, но пока не проиндексирована | Google уже сканировал URL, но не включил его в индекс. | Фактически полученный контент, канонические сигналы, схожесть материалов и их ценность. |
| Страница является копией | Google определил другой URL как канонический. | Проверка выбранного Google canonical и необходимости отдельной страницы. |
Эти статусы нельзя смешивать. Если страница уже просканирована, рекомендации «просто откройте ее для робота» часто не отвечают на основной вопрос. А если она вообще не была просканирована, оценивать решение Google о качестве ее содержимого преждевременно.
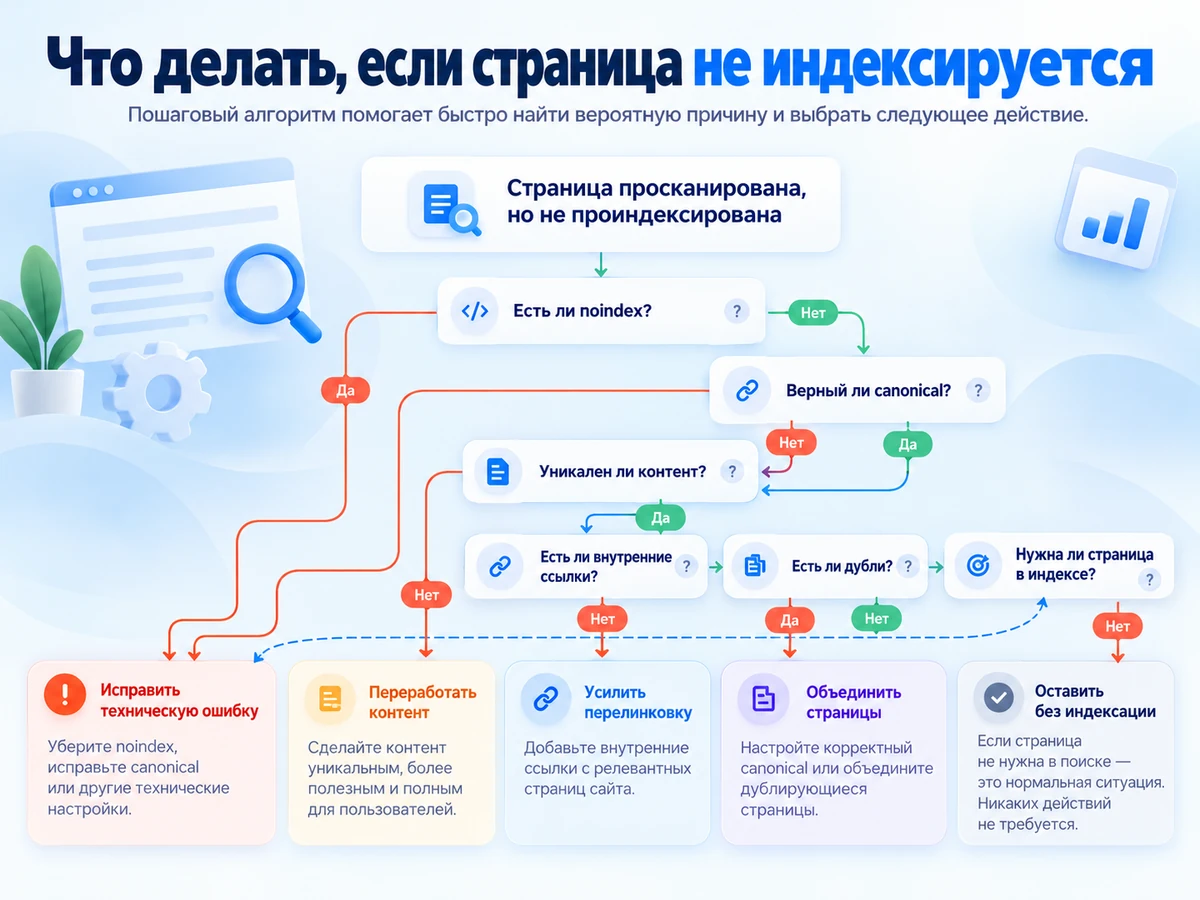
Первые действия: диагностика в Google Search Console за 10–15 минут
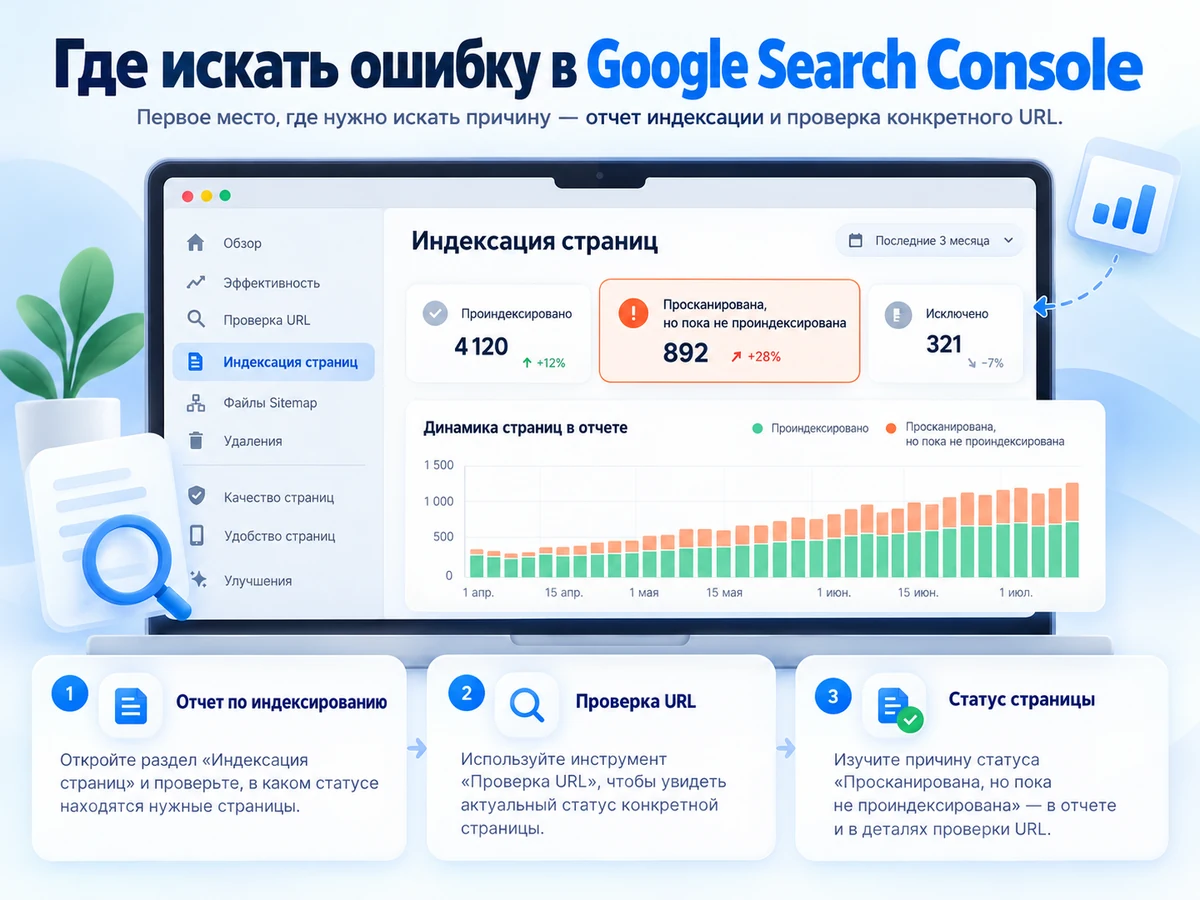
- Откройте «Индексирование → Страницы». Выберите причину «Страница просканирована, но пока не проиндексирована». Посмотрите график: проблема появилась вчера, нарастает месяцами или затронула сайт одномоментно?
- Выберите действительно важный URL. Для начала проверяйте страницу услуги, категорию, полезную статью или карточку с самостоятельным спросом - не случайный параметрический адрес.
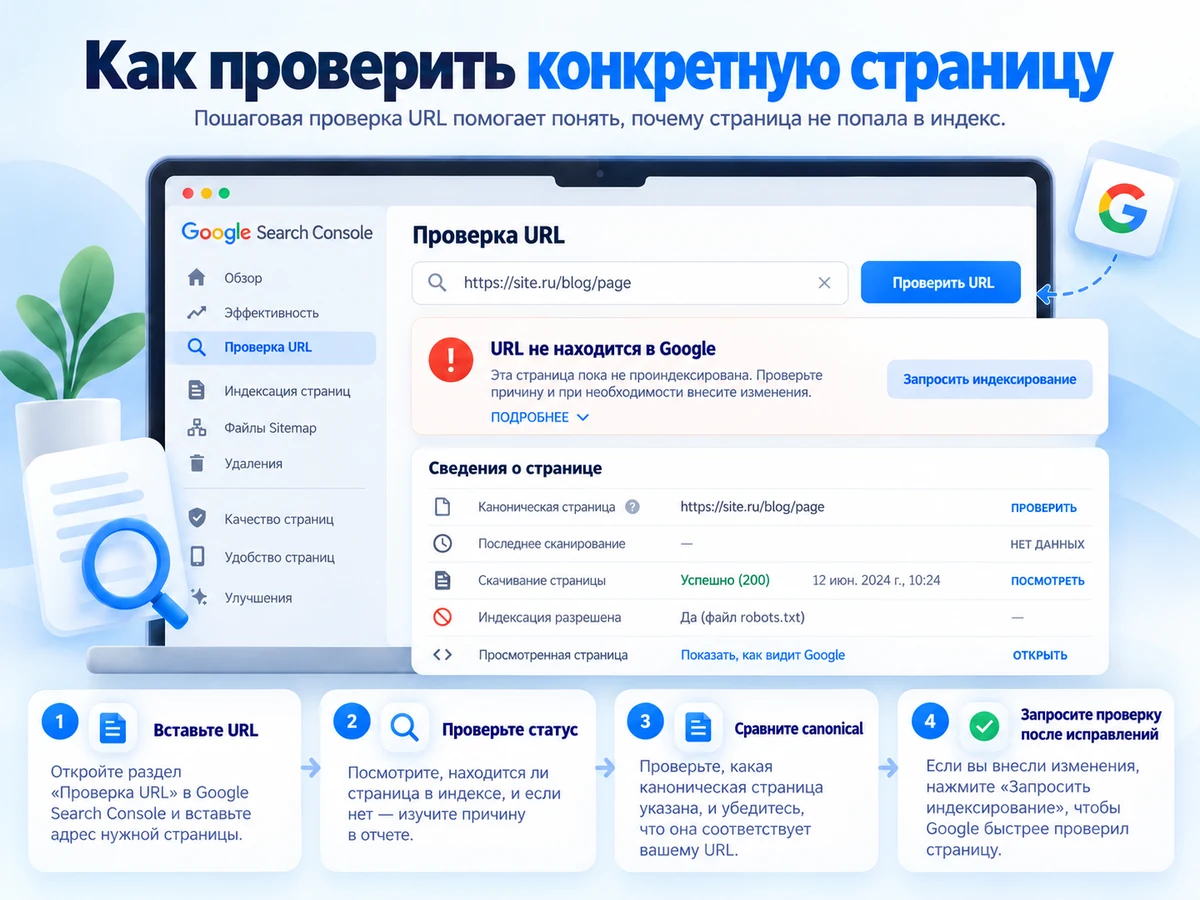
- Откройте «Проверка URL». Введите полный адрес и изучите дату последнего сканирования, статус получения страницы, сведения об индексировании, наличие ссылок на нее и данные о канонической версии, если они доступны.
- Сравните старые данные и текущую версию. Нажмите «Проверить страницу на сайте» (в некоторых интерфейсах - проверка опубликованного URL). Отчет об индексировании отражает прошлое состояние; текущая проверка показывает, доступна ли страница для обработки сейчас.
- Посмотрите HTML, скриншот и ресурсы. В блоке просмотра проверенной страницы убедитесь, что Google видит не пустой шаблон, а основной текст, заголовок, товары или содержимое статьи.
- Сопоставьте с проиндексированным аналогом. Возьмите близкую по типу успешную страницу и сравните технические сигналы, полноту контента, дублирование и внутренние ссылки.
Не путайте: успешная проверка опубликованного URL показывает, что страница технически может быть обработана. Она не обещает включения в индекс и не определяет окончательно каноническую страницу. Данные о выборе canonical следует смотреть в результатах индексирования, когда Google их предоставляет.
Технические причины: что нужно исключить в первую очередь
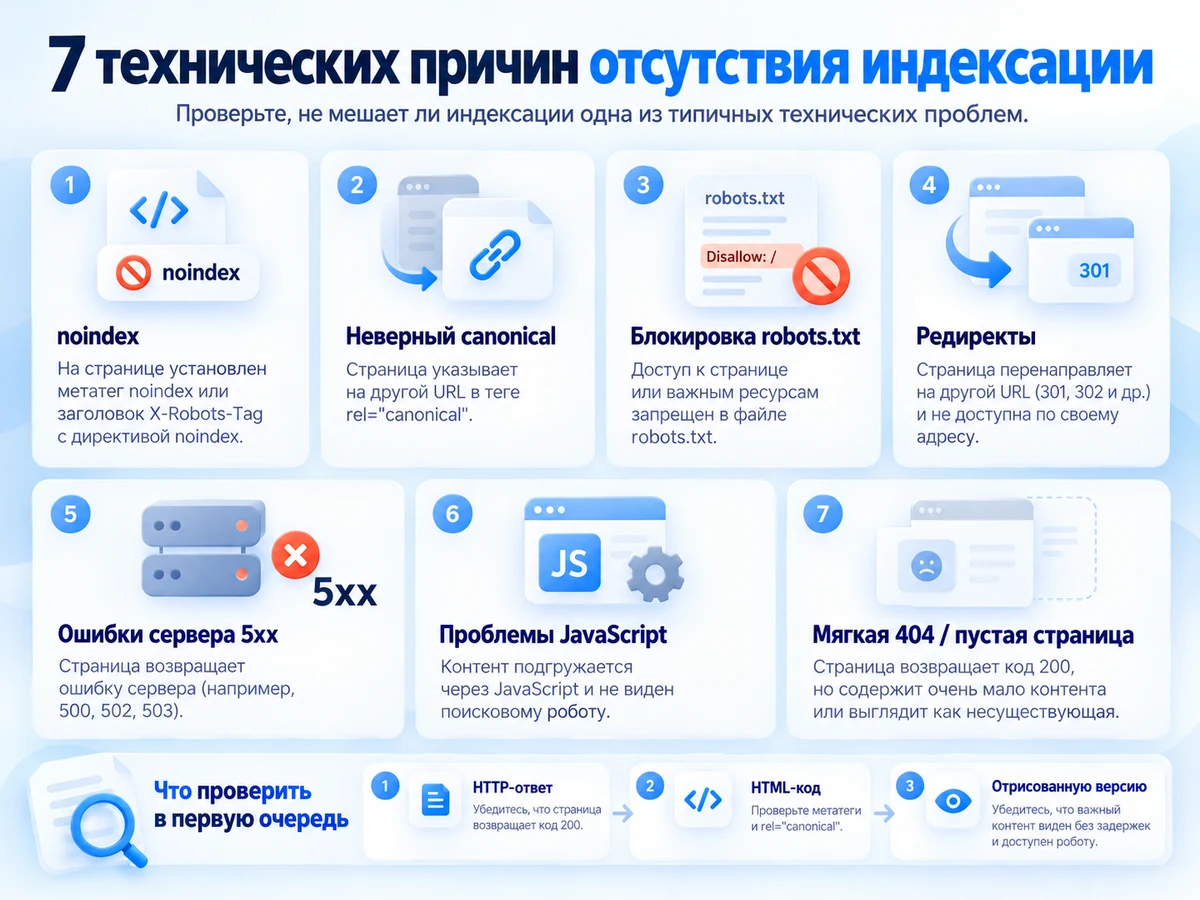
1. Какой контент на самом деле получает Google?
Страница может прекрасно открываться у владельца сайта, но отображаться пустой у поискового робота. Особенно это актуально для сайтов с клиентским JavaScript: браузер пользователя подгружает данные, а при рендеринге у Google не появляется основная часть содержимого.
Проверьте исходный и обработанный HTML, скриншот, ошибки JavaScript, ответы API и доступность нужных ресурсов. Если вместо текста услуги вы видите только меню и индикатор загрузки, нужно исправлять рендеринг: обеспечить доступный HTML с основным содержимым, настроить SSR/статическую генерацию там, где это оправданно, либо устранить ошибки получения данных.
2. Корректен ли ответ сервера?
В момент проверки важная страница обычно должна стабильно отвечать 200 OK, а не выдавать серверную ошибку, редирект на другой раздел или страницу-заглушку. Проверьте поведение для обычного посетителя и Googlebot, историю ошибок 5xx, работу CDN/WAF и логи сервера при наличии доступа.
Отдельная ловушка - soft 404: сервер возвращает код 200, но страница фактически сообщает «ничего не найдено», «товаров нет» или почти полностью пуста. Google может классифицировать ее отдельно как ложную 404. Это соседний сценарий диагностики, а не синоним статуса «Просканирована, не проиндексирована».
3. Нет ли конфликтующих директив?
Проверьте robots.txt, метатег robots, HTTP-заголовок X-Robots-Tag, редиректы и rel="canonical". Например, у важной страницы не должно случайно оказаться <meta name="robots" content="noindex">.
Однако есть нюанс: явные блокировки noindex и robots.txt Google обычно показывает в других категориях отчета. Поэтому не стоит объявлять их причиной только на основании рассматриваемого статуса. Их проверяют, чтобы исключить изменения после последнего обхода и ошибки конфигурации.
4. Правильную ли версию страницы мы пытаемся индексировать?
Проверьте версии с http/https, www и без, с завершающим слешем, параметрами URL, а также canonical-ссылку. Канонический адрес должен соответствовать реальной предпочтительной версии страницы. При расхождении сигналов Google может выбрать другую страницу; конкретное решение проверяют через инспекцию URL.
Если с технической стороны все выглядит исправно, полезен комплексный SEO-аудит сайта: он помогает проверить не только один адрес, но и повторяющиеся ошибки шаблонов, рендеринга, перелинковки и индексации.
Как понять, что проблема не в коде, а в содержимом страницы
Частая ситуация: HTML доступен, Google видит текст, запретов на индексирование нет, но URL остается исключенным. Следующий шаг - не менять наугад Title, а оценить, зачем поисковику хранить именно эту страницу.
Для оценки задайте семь вопросов:
- Есть ли у страницы отдельная задача? Она отвечает на самостоятельный поисковый запрос или повторяет уже существующий материал?
- Есть ли уникальная полезная информация? Не только новый набор слов, а собственные примеры, сравнения, инструкции, цены, характеристики, фотографии, данные или экспертные выводы.
- Соответствует ли содержание намерению пользователя? Если ищут «стоимость», недостаточно статьи об истории услуги; если нужен выбор товара - одной рекламной фразы мало.
- Не слишком ли много шаблонного текста? Особенно на городских, товарных и услуговых страницах, различающихся одной подстановкой.
- Есть ли доверие к информации? Понятен ли автор или ответственная организация, откуда взялись факты, когда сведения актуализировали?
- Удобно ли пользоваться страницей? Видно ли главное содержание без навязчивых блоков, работает ли мобильная версия, есть ли понятная структура?
- Что получит посетитель именно здесь? Можно ли в одном предложении объяснить преимущество этой страницы перед похожими материалами сайта и конкурентами?
Объем сам по себе не является «порогом индексации». Страница может быть короткой и очень полезной. В то же время длинный материал с повторениями, общими фразами и без новых фактов не становится автоматически качественным.
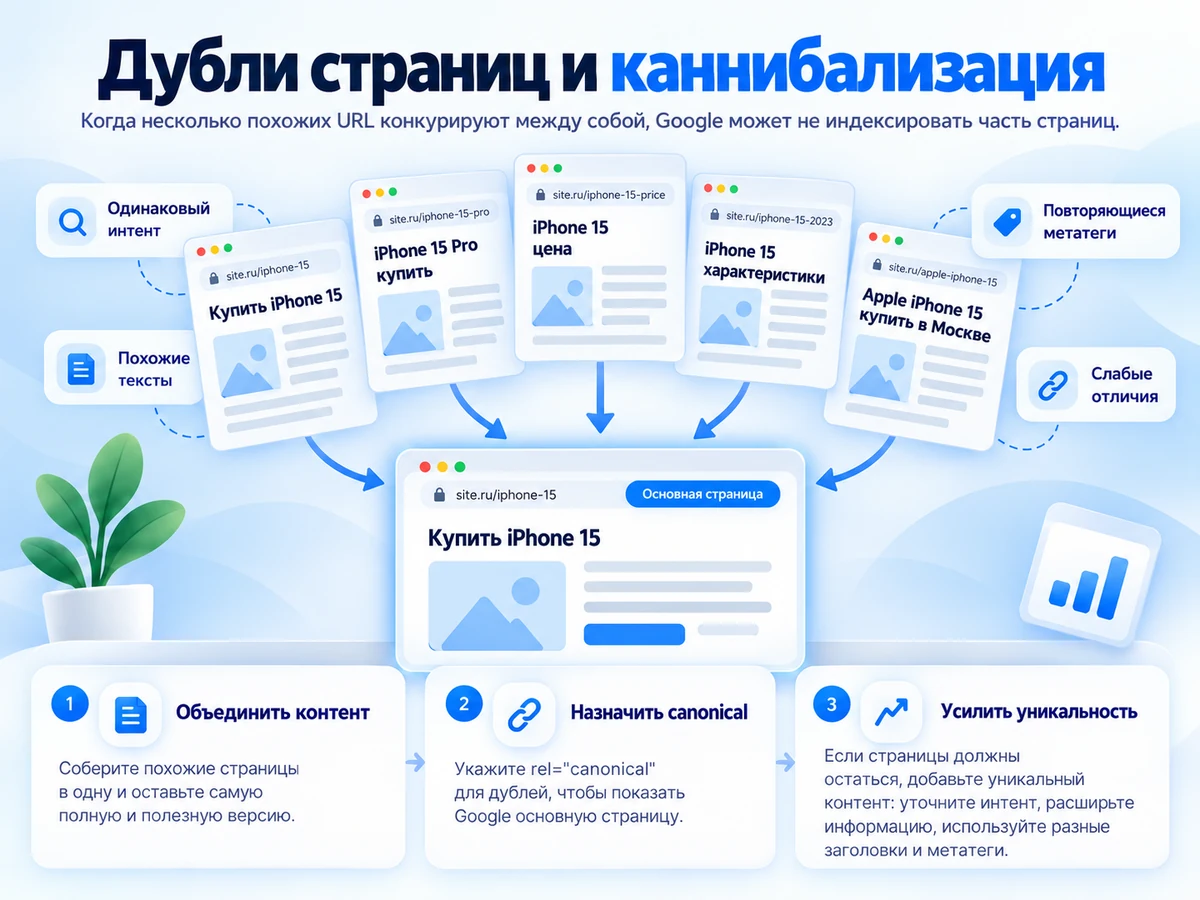
Дубли и каннибализация: когда на сайте слишком много страниц про одно и то же
Иногда проблема находится не в конкретной странице, а в ее соседях. Например, на сайте одновременно существуют материалы «Как проверить индексацию страницы», «Почему страница не индексируется» и «Google не добавляет URL в поиск», причем везде почти одинаковые определения и советы.
Такие URL необязательно являются техническими копиями, но могут конкурировать за один поисковый интент. Это называют контентным пересечением или каннибализацией. Само наличие нескольких похожих страниц не доказывает причину исключения из индекса - важно оценить фактическую разницу между ними.
Что делать при сильном пересечении
- Оставить одну основную страницу, если остальные не решают самостоятельную задачу.
- Перенести полезные фрагменты из слабых дублей в основной материал.
- Использовать
301для удаляемых URL только при наличии подходящего нового адреса и обоснованного объединения. - Развести материалы по разным интентам, если потребности пользователей действительно различаются.
- Выстроить понятные внутренние ссылки между обзорной и узкоспециализированными страницами.
Не ставьте canonical на непохожую страницу только ради «исправления» статуса. Этот тег предназначен для указания предпочтительного URL среди одинаковых или очень близких версий контента, а не для принудительного индексирования.
Внутренние ссылки и Sitemap: почему одной карты сайта недостаточно
Файл sitemap.xml сообщает поисковику о важных URL, но не обязывает Google индексировать их. Если страница присутствует только в Sitemap и на нее нельзя попасть через обычную навигацию, стоит пересмотреть структуру.
Убедитесь, что нужный материал:
- связан ссылками из релевантной категории, раздела или тематических статей;
- не спрятан исключительно за поиском по сайту или JavaScript-действием, недоступным роботу;
- имеет понятный анкор, объясняющий содержание страницы;
- не конфликтует с другой страницей, на которую вы подаете противоположные canonical-сигналы;
- включен в XML Sitemap, если должен индексироваться, причем с правильным каноническим URL.
Внутренняя перелинковка помогает обнаружению и пониманию структуры, но не является волшебным переключателем индексации. Бесполезная страница не станет полезной только потому, что на нее добавили десять ссылок.
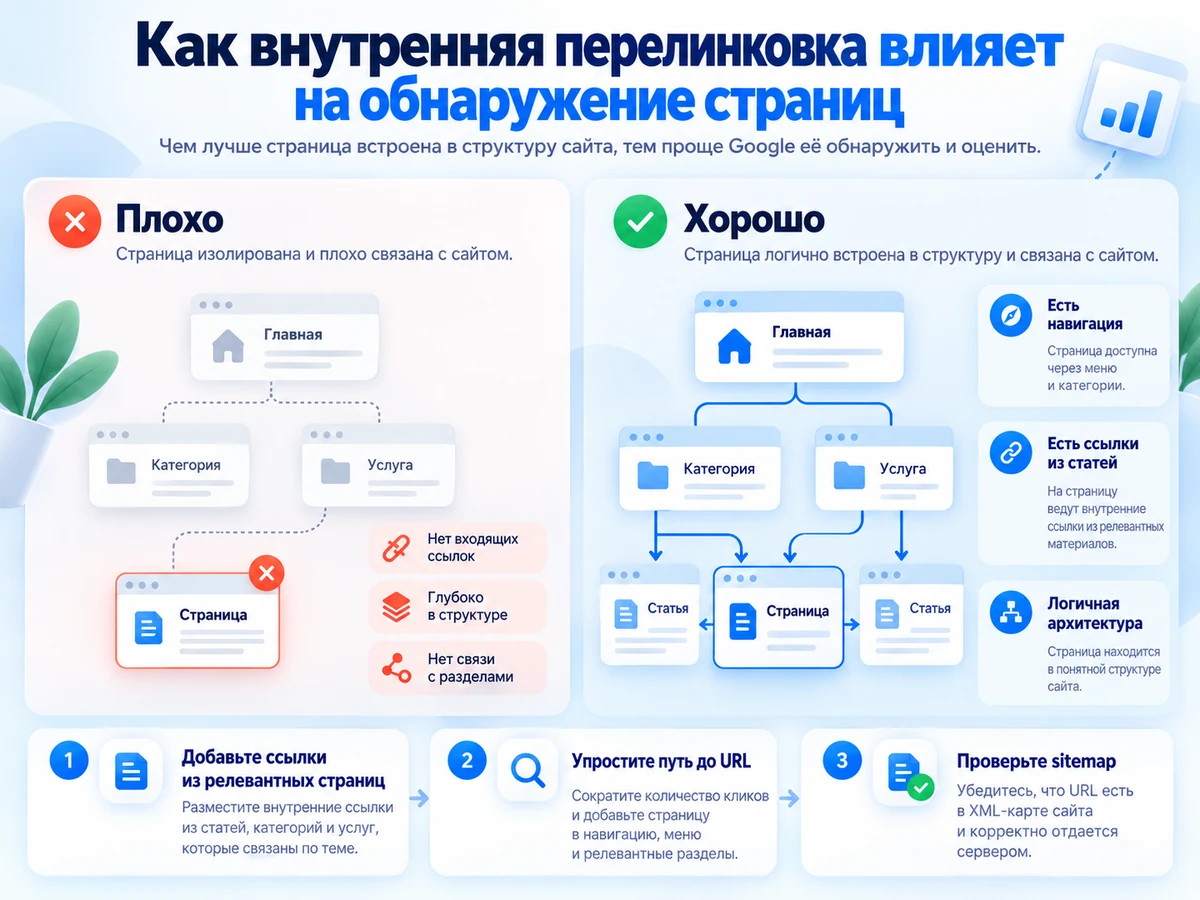
Таблица диагностики: симптом, возможная причина и действие
| Что вы наблюдаете | Что проверить | Что делать |
|---|---|---|
| Статья опубликована недавно, проверка без явных проблем | Дата первой публикации, последний обход, структура сайта | Не делать поспешных выводов; наблюдать и улучшать обнаружение. |
| В проверенном HTML отсутствует основной текст | JavaScript, API, SSR, ошибки рендеринга | Обеспечить доступность основного контента для Google. |
| Есть другая статья на ту же тему | Пересечение интентов, повторяющиеся блоки, выбранный canonical | Развести темы, усилить уникальную пользу или объединить материалы. |
| Сотни региональных страниц отличаются названием города | Шаблонность, реальные отличия предложений и географическая релевантность | Оставить обоснованные посадочные, наполнить их содержательными региональными данными; убрать избыточные дубли. |
| Карточки товаров почти пустые | Характеристики, изображения, наличие, описания, альтернативы | Улучшить карточки и логику каталога; не требовать индексации каждого URL. |
| Страница возвращает 200, но на ней «ничего не найдено» | Фактический контент, возможная soft 404, поведение шаблона | Показать полезную страницу или возвращать корректный HTTP-статус. |
| На нужный URL нет внутренних ссылок | Меню, каталог, хлебные крошки, тематические связи | Добавить уместные HTML-ссылки из индексируемых разделов. |
| После редизайна массово пропали URL из индекса | Дата запуска, логи, canonical, robots, редиректы, изменение шаблонов | Искать общий технический фактор до переписывания контента. |
Таблица показывает рабочие гипотезы, а не официальные однозначные причины для каждого URL: Search Console не предоставляет «скоринг качества» страницы и не объясняет все решения об индексировании.
На каких страницах проблемы возникают чаще и что проверять
Информационные статьи
Оцените оригинальность ответа и полноту решения задачи. Если статья лишь пересказывает известные определения, добавьте практические примеры, собственные исследования, иллюстрации, сравнения, ограничения и проверяемые источники. Важно не количество блоков, а полезность каждого.
Страницы услуг
Проверьте, видно ли конкретное предложение: что входит в работу, для кого услуга, как проходит процесс, какие результаты подтверждаются кейсами, какие факторы влияют на стоимость. Одинаковые текстовые заготовки у десяти услуг затрудняют понимание их различий. Если проблема затрагивает важные коммерческие URL, системная работа над продвижением сайта в Google включает техническую и содержательную части.
Карточки товаров и категории
У магазина могут появляться тысячи адресов из фильтров, сортировок, пагинации и вариаций товара. Индексировать все подряд не нужно. Выделяйте категории с реальным спросом, полноценные карточки и полезные фильтры. Для большого каталога критична архитектура: подробнее о подходе - на странице SEO-продвижения интернет-магазинов.
Региональные посадочные
Если страницы Москвы, Санкт-Петербурга и еще двадцати городов отличаются только названием населенного пункта, поисковику может быть сложно увидеть самостоятельную ценность каждого URL. Проверьте наличие реальных локальных особенностей: состава услуг, подтвержденных объектов, условий работы, информации о команде или точках присутствия. Не выдумывайте адреса и кейсы ради «уникализации».
Что делать, если Google не индексирует сотни или тысячи страниц
При массовой проблеме разбирать URL по одному неэффективно. Сначала нужно искать повторяющийся шаблон. Выгрузите список затронутых адресов из Search Console и сгруппируйте их по типам: статьи, категории, товары, регионы, фильтры, служебные адреса.
- Определите долю важных посадочных среди исключенных URL: количество само по себе не показатель ущерба.
- Сравните новые и ранее индексировавшиеся страницы; отдельно отметьте дату массового изменения.
- Для каждой группы проверьте несколько URL: один с проблемой и один успешно индексируемый.
- Сопоставьте шаблоны, внутренние ссылки, объем полезного контента, рендеринг, canonical и ответы сервера.
- Исправляйте источник ошибки на уровне шаблона или структуры, если он повторяется, а не вручную на каждой странице.
При работе с данными Google полезно видеть разницу между показами страниц, их состоянием в Search Console и фактическим поисковым трафиком. Дополнительно рекомендуем материал о новом отчете генеративного ИИ в Google Search Console: он поможет разобраться, как интерпретировать поисковые данные, хотя сам по себе не предназначен для диагностики индексирования.
Пошаговый план: как вернуть важные страницы в зону индексирования
- Определите приоритет. Отделите значимые посадочные от дублей и технических URL.
- Зафиксируйте исходные данные. Запишите статус, дату последнего сканирования, ключевые технические параметры, наличие показов и внутренних ссылок.
- Проверьте фактическую доступность. Изучите HTTP-ответ, рендеринг и содержимое, которое видит Google.
- Разберите сигналы каноничности. Убедитесь, что сам сайт не подталкивает Google к выбору другого адреса.
- Сравните страницы внутри сайта. Найдите контентные дубли, слабые шаблоны и пересечения по интенту.
- Усильте реальную пользу. Добавьте недостающую информацию, примеры, данные, доказательства опыта и удобные элементы навигации.
- Улучшите место страницы в структуре. Свяжите ее с релевантными разделами, проверьте Sitemap и HTML-ссылки.
- Проверьте исправления и отслеживайте результат. После значимых изменений проверьте текущий URL и при необходимости один раз запросите индексирование для приоритетной страницы. Оценивайте результат по более поздним данным Search Console, а не по мгновенной смене статуса.
Не существует гарантированного срока, за который исправленная страница войдет в индекс. Время зависит от характера изменений, обхода и решения поисковой системы. Если техническая проверка проходит успешно, но статус не меняется, возвращайтесь к вопросу о самостоятельной пользе страницы и конкурентных альтернативах, а не отправляйте URL на переобход каждый день.
Семь ошибок, которые мешают разобраться с проблемой
- Нажимать «Запросить индексирование» ежедневно. Это не заменяет устранение причины и не гарантирует результат.
- Переписывать Title и Description наугад. Метатеги полезны, но не компенсируют отсутствие самостоятельной ценности страницы.
- Добавлять тысячи слов ради объема. Текстовая масса не равна качеству ответа.
- Ставить canonical на чужую по смыслу страницу. Такой подход создает противоречивые сигналы.
- Считать все исключенные URL ошибками. У технических вариантов страниц может не быть причин находиться в индексе.
- Делать вывод только по запросу
site:. Оператор не показывает исчерпывающий и надежный список проиндексированных URL; для конкретной страницы используйте Search Console. - Менять все одновременно. Если одновременно переписать текст, перестроить адреса и изменить canonical, позже сложнее понять, какое изменение помогло или навредило.
Чек-лист перед повторной проверкой
- URL действительно должен находиться в индексе.
- Google может открыть страницу, а сервер стабильно отвечает корректно.
- Основное содержимое видно в проверенном HTML или после рендеринга.
- Нет случайной директивы
noindexи противоречивых блокировок. - Канонический URL определен правильно, версии адреса согласованы.
- Страница решает отдельную задачу и не дублирует другой URL.
- Контент содержит полезные детали, факты или практический опыт.
- На страницу ведут подходящие внутренние HTML-ссылки.
- В Sitemap перечислены нужные канонические адреса.
- После изменений зафиксирована дата, чтобы корректно оценить повторный обход.
Частые вопросы
Если страница просканирована, значит ли это, что Google считает ее плохой?
Нет. Статус лишь сообщает, что URL был просканирован, но сейчас не индексируется. Среди возможных объяснений - обработка новой страницы, недостаточная самостоятельная ценность, пересечения с другими материалами или особенности рендеринга. Точную причину из одной строки отчета определить нельзя.
Сколько ждать индексации после публикации?
Фиксированного срока нет. Новые страницы могут появляться в индексе через несколько дней, а некоторые не индексируются и после длительного ожидания. Оценивайте динамику, важность URL и результаты диагностики, а не универсальный «норматив».
Нужно ли повторно отправлять URL в Google Search Console?
Для самого статуса «Просканирована, но пока не проиндексирована» Google не требует повторной отправки. После существенного исправления важной страницы можно запросить индексирование, но многократные запросы не повышают гарантию успеха.
Может ли Google не индексировать качественную страницу?
Да. Даже технически корректная и полезная страница не имеет гарантированного права на индексацию. Стоит оценить ее отличие от других материалов, структуру сайта и поисковую потребность.
Поможет ли sitemap.xml?
Он полезен для обнаружения нужных URL, но не заставляет Google включать их в индекс. Особенно важно, чтобы Sitemap, canonical и внутренняя навигация не противоречили друг другу.
Есть ли смысл удалять страницу и создавать заново под другим URL?
Обычно нет. Замена адреса без исправления причины лишь создает дополнительную работу для поискового робота и риск потери сигналов старой страницы. Менять URL стоит по самостоятельным структурным причинам, а не ради обхода статуса.
Если URL прошел проверку опубликованной страницы, он попадет в индекс?
Нет. Такая проверка показывает доступность и техническую возможность обработки текущей версии. Она не оценивает все сигналы качества и не гарантирует индексацию.
Важные страницы не попадают в Google?
В GiperBaton начинаем не с массовой отправки URL на переобход, а с диагностики: какие страницы действительно нужны бизнесу, что видит Google, где повторяются ошибки шаблонов и каких сигналов не хватает. По результатам формируем понятный план работ - от технических исправлений до доработки структуры и контента.
Обсудить проблему с индексацией →Официальная документация и дополнительные материалы
- Google: отчет об индексировании страниц.
- Google: инструмент проверки URL.
- Google Search Central: устранение проблем с JavaScript.
- Как попасть в ответы ИИ Google: AI Overviews и AI Mode - о требованиях к видимости контента в новых поисковых интерфейсах.