
В Яндекс Вебмастере появилась причина исключения «Малоценная или маловостребованная страница»? Не спешите переписывать все тексты, удалять URL или массово отправлять их на переобход. Сначала выясните, почему конкретная страница не нужна поиску и действительно ли она должна привлекать посетителей.
Короткий ответ. Проверьте доступность страницы для робота, наличие основного контента в HTML, дубли, соответствие поисковому спросу и внутренние ссылки. Если URL нужен для SEO - устраните конкретную причину, улучшите страницу и отправьте ее на переобход. Если это дубль или служебный адрес - правильно объедините либо исключите его из поиска. Сам статус не является санкцией Яндекса.
Официальное обозначение статуса в выгрузке Яндекс Вебмастера - LOW_DEMAND. Он объединяет несколько сценариев, поэтому универсального исправления не существует.
Что означает «Малоценная или маловостребованная страница»
Яндекс не обязан включать в результаты поиска каждую обнаруженную страницу. После обхода и обработки содержимого алгоритм оценивает, есть ли смысл показывать конкретный URL пользователям. Если шансов на полезный показ мало, страница может получить статус LOW_DEMAND.
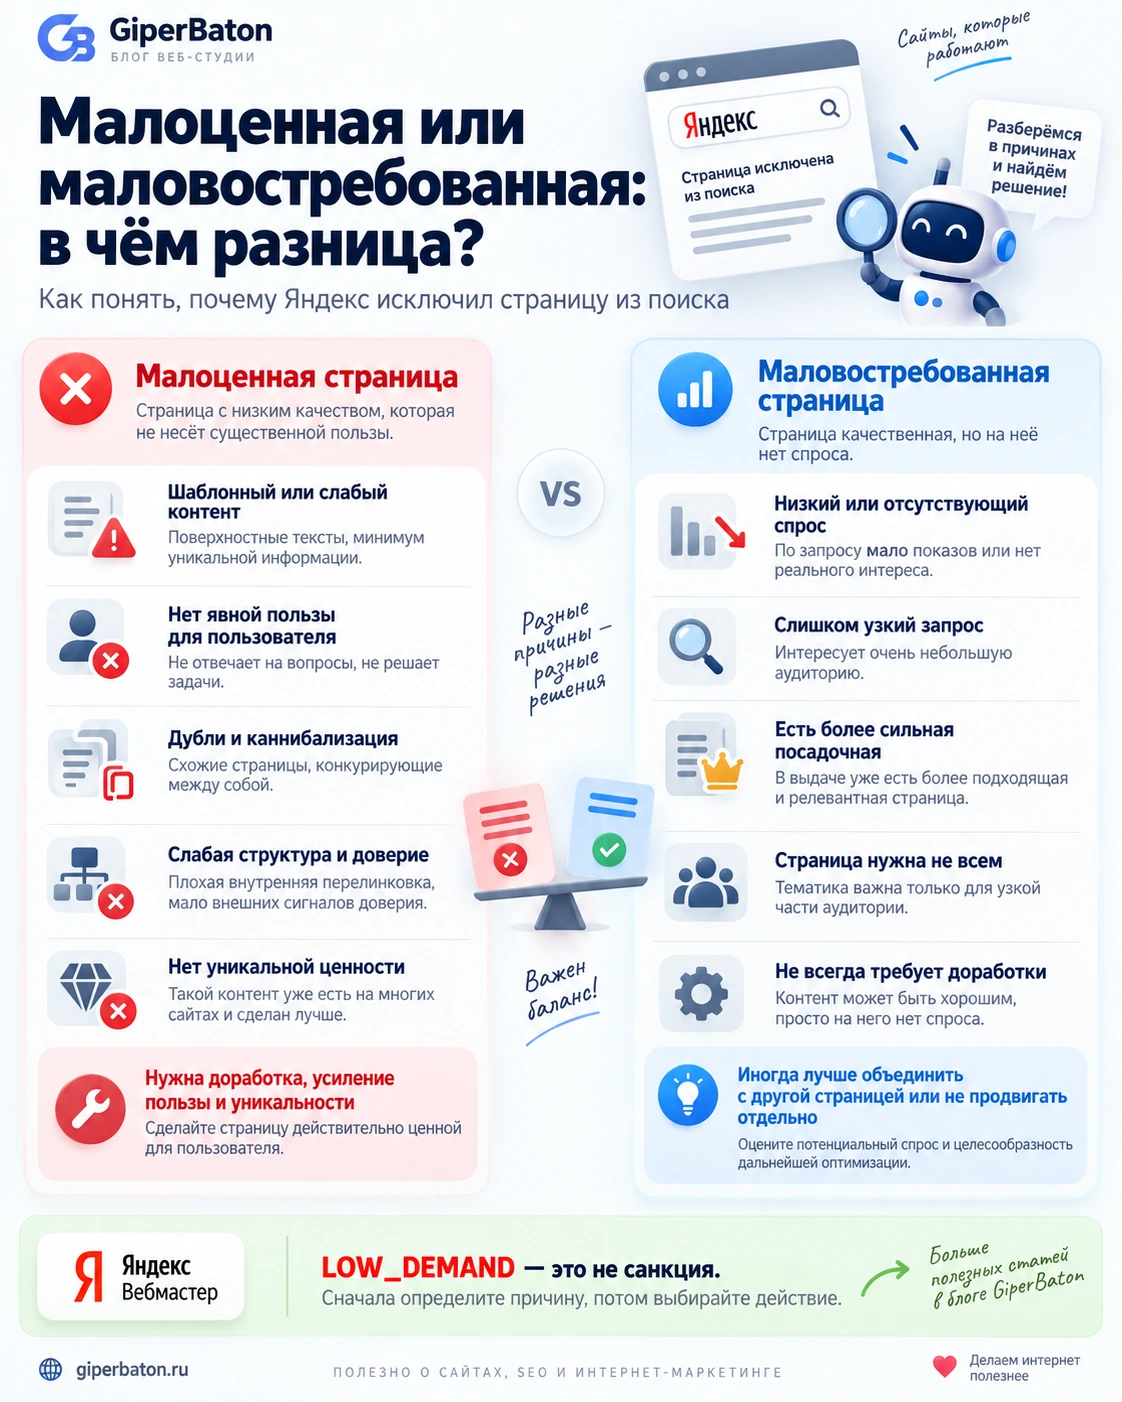
Важно не путать две разные ситуации. В интерфейсе они объединены одним статусом, но для владельца сайта требуют разных решений.
| Ситуация | Что происходит | Куда смотреть в первую очередь |
|---|---|---|
| Малоценная | Робот видит мало содержимого или страницу, очень похожую на другую. | HTML-контент, JavaScript, шаблон, дубли, canonical, полнота информации. |
| Маловостребованная | Контент есть, но алгоритм не видит подходящих запросов и перспектив полезного показа. | Семантика, интент, соответствие формулировкам запросов, выбор посадочного URL. |
Например, карточка товара может быть пустой для робота из-за загрузки данных скриптом. А подробная статья может не соответствовать тому, что люди действительно ищут по ее теме. Одинаковый статус - разные причины.
Важно: Яндекс не показывает для каждого URL отдельную точную формулу, почему тот получил LOW_DEMAND. Причину определяют диагностикой, а не по названию статуса.
Где посмотреть малоценные и маловостребованные страницы в Яндекс Вебмастере
- Откройте Яндекс Вебмастер и выберите нужный сайт.
- Перейдите в раздел «Индексирование» → «Страницы в поиске».
- Переключитесь на «Исключенные страницы».
- Установите фильтр по причине «Малоценная или маловостребованная страница».
- Выгрузите URL и сгруппируйте их по разделам: услуги, товары, категории, статьи, города, параметры фильтра.
Полезно сохранить дату последнего обхода, заголовок, текущий статус и историю изменений. Отдельно сопоставьте список с целевыми страницами, которые были в поиске и приносили переходы раньше. В Метрике и статистике поисковых запросов ищите потери важных посадочных страниц, а не только рост общего числа исключенных URL.
Для конкретного адреса используйте «Индексирование» → «Проверка страницы» и инструмент проверки ответа сервера. Они помогут отделить проблему содержания от ошибки доступа.
Опасно ли это для сайта и означает ли фильтр Яндекса?
Нет, сам по себе статус LOW_DEMAND не означает наложение фильтра или санкции на сайт. В официальной справке Яндекса прямо указано, что наличие таких страниц не свидетельствует о нарушениях и ограничениях ранжирования. Количество исключенных страниц также не является самостоятельным негативным сигналом для позиций остальных URL.
Но есть практическая разница между двумя случаями:
В поиске нет 2 000 технических URL
Если это сортировки, пустые фильтры и адреса с параметрами, исключение может быть нормальным. Проверяйте, не мешают ли они обходу важных страниц.
В поиске нет 80 страниц услуг
Если это основные коммерческие посадочные страницы, сайт может терять показы, переходы и заявки. Здесь нужна приоритетная диагностика.
Если подозреваете реальные ограничения, проверьте в Вебмастере «Оптимизация сайта» → «Безопасность и нарушения». Не смешивайте этот раздел с причинами обычного исключения страниц.
Нет «лимита индекса». Яндекс отдельно разъясняет, что не устанавливает квоту на количество страниц сайта, которые могут попасть в поиск. Поэтому цель работ - не добиться условных «90 % URL в индексе», а обеспечить присутствие нужных и полезных страниц.
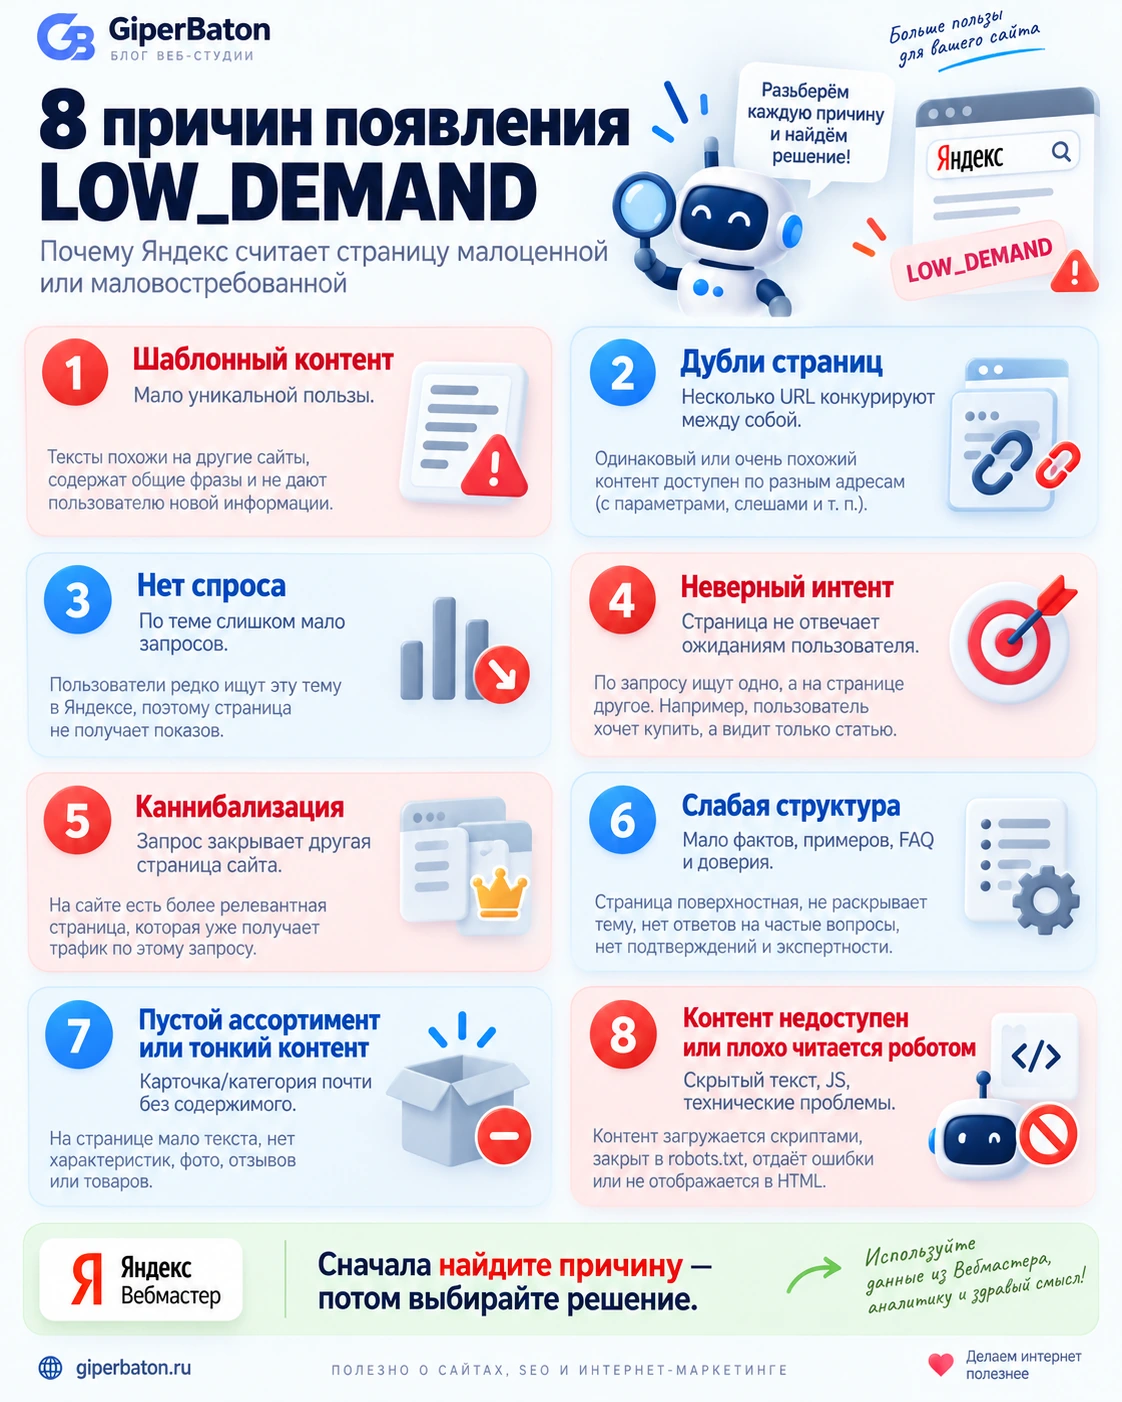
Почему Яндекс считает страницы малоценными: основные причины
Следующие сценарии - не секретный список факторов и не автоматический диагноз. Это наиболее полезные гипотезы, которые нужно проверить на реальных URL.
1. Дубли и почти одинаковые URL
Разные адреса с одинаковой услугой, товарами, UTM-параметрами, сортировкой или очень похожими региональными шаблонами.
2. Пустой HTML для робота
Основная информация появляется только после выполнения JavaScript, находится в iframe или представлена изображением вместо текста.
3. Формально заполненная, но слабая страница
Есть H1 и несколько общих абзацев, однако нет ответа на основную задачу пользователя: условий, выбора, конкретики или полезных данных.
4. Страница не соответствует интенту
По запросу ожидают сравнение товаров, а получают рекламную страницу; ищут инструкцию, а видят каталог без объяснений.
5. Нет самостоятельного спроса
Под крайне узкую комбинацию слов создан отдельный URL, хотя пользователи ищут более общую тему или вариант совсем другой формулировкой.
6. Каннибализация страниц
Несколько публикаций или услуг пытаются ответить на один и тот же набор запросов. Алгоритм может предпочесть один документ.
7. Пустой ассортимент или устаревшее содержание
Категория без товаров, карточка давно недоступной модели, архивная акция без полезной информации для посетителя.
8. Неправильный выбор посадочной страницы
Тема имеет спрос, но находится в неподходящем разделе; нет понятных ссылок с родительских страниц и связи с общей структурой.
Объем текста сам по себе не решает проблему. Короткая страница с точным ответом может быть полезнее длинного SEO-текста, который не помогает человеку выполнить задачу.
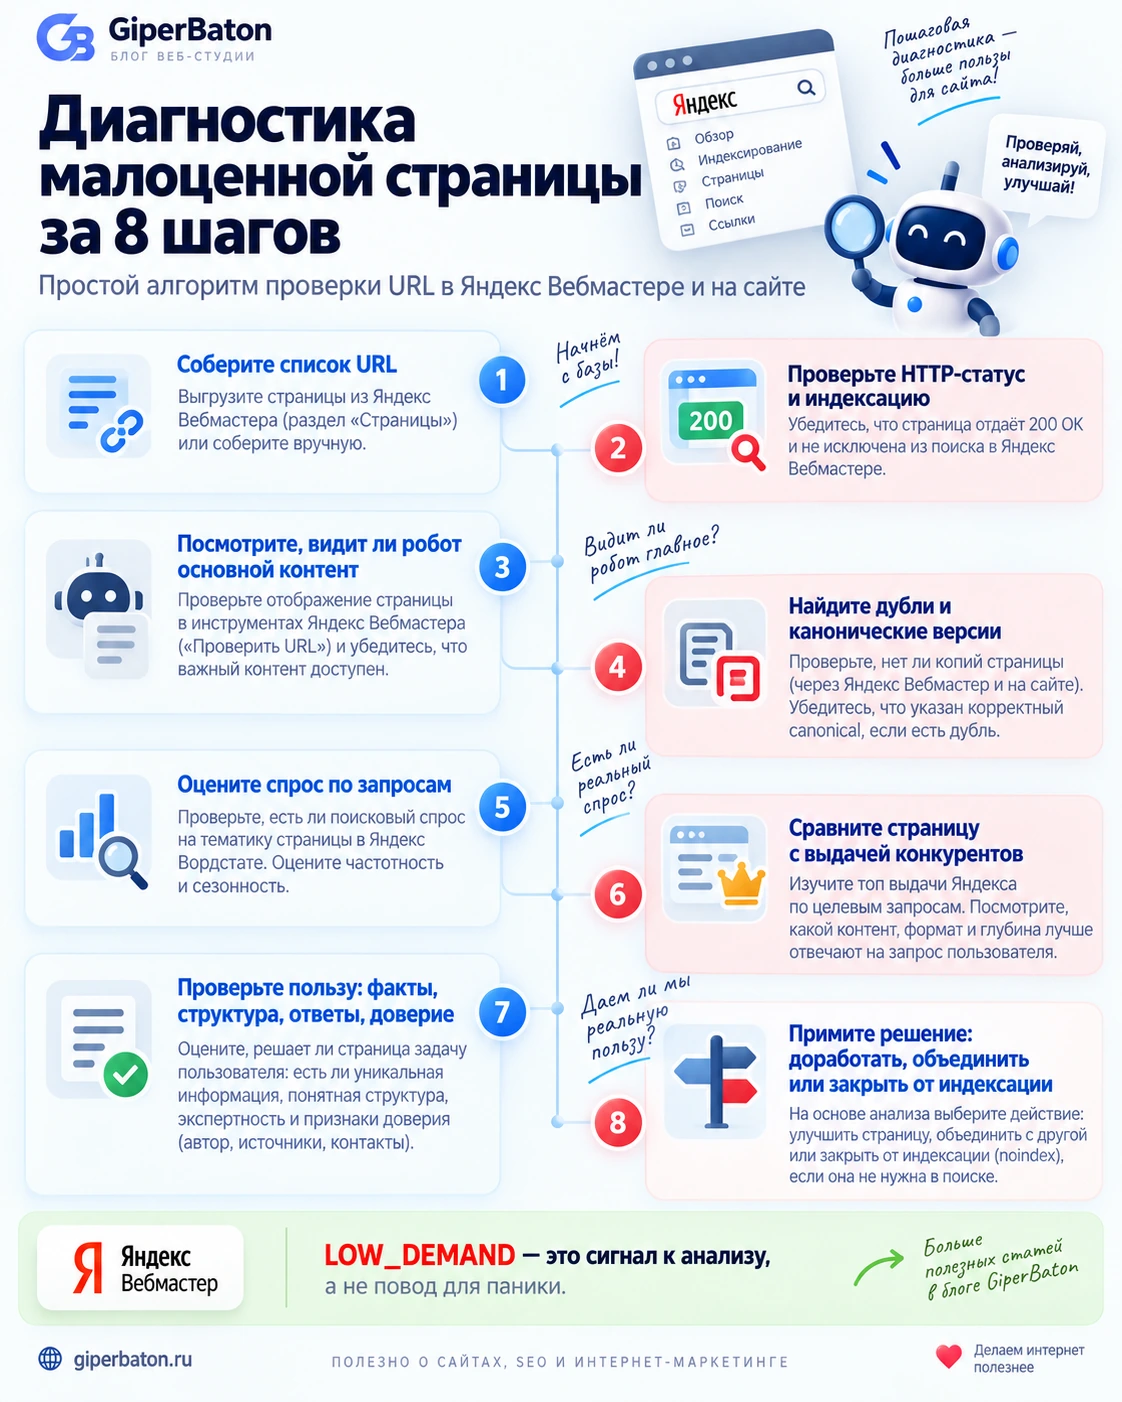
Что делать: диагностика LOW_DEMAND за 8 шагов
Начинать лучше с выборки важных URL, а не с одновременной правки тысяч страниц. Вот последовательность, которая помогает найти причину и не навредить работающим разделам.
-
Разделите исключенные URL на группы
Соберите таблицу: URL → тип страницы → статус → дата обхода → коммерческая ценность → прошлые клики → предполагаемая причина → действие. Смотрите, сосредоточена ли проблема в одном шаблоне, категории, регионе или месяце публикации.
-
Проверьте код ответа и разрешение на индексацию
Для нужной страницы ожидается корректный ответ
200 OK, доступность для робота, отсутствие случайногоnoindexи запрета вrobots.txt. Проверьте редиректы и значениеrel="canonical". Эти ошибки могут давать и собственные статусы исключения, поэтому нельзя автоматически списывать все на контент. -
Посмотрите на страницу глазами робота
Сравните содержание в обычном браузере и HTML, который получает робот через проверку ответа сервера. Видны ли название товара, описание услуги, цены, характеристики, основной текст и ссылки? Если значимая информация есть только после выполнения скриптов, изучайте рендеринг и возможность отдавать ее в исходном HTML.
-
Найдите дубли и конкурирующие URL
Сравните H1, заголовки, ассортимент и основной контент. Проверьте, не существуют ли одновременно
/usluga/и/usluga/?sort=popular, две статьи об одной проблеме или десятки почти одинаковых городских страниц. Решите, нужны ли они в поиске отдельно. -
Проверьте, как люди формулируют запрос
Используйте Яндекс Вордстат, статистику поисковых запросов Вебмастера и реальные поисковые подсказки. Смотрите нужный регион, синонимы, смежные формулировки, сезонность и тип намерения. Нулевая частотность одной точной фразы не доказывает, что страница бесполезна.
-
Сравните страницу с реальной выдачей
Изучите результаты по нескольким приоритетным запросам. В выдаче преобладают инструкции, карточки, категории, калькуляторы, коммерческие услуги или обзоры? Ваш URL должен отвечать на то же намерение, но со своей реальной пользой.
-
Усилите ответ на главную задачу посетителя
Добавьте только то, чего действительно не хватает: характеристики, варианты, примеры, таблицу выбора, цены или принципы расчета, фото процесса, ограничения, инструкции и вопросы клиентов. Не копируйте текст конкурентов и не наращивайте объем ради количества символов.
-
Проверьте внутренние ссылки и повторно оцените статус
Важная страница должна быть доступна из релевантных разделов, а в
sitemap.xmlжелательно оставлять актуальные канонические URL. После исправлений отправьте выбранные адреса на переобход и отслеживайте результат, показы и клики, а не только изменение подписи в Вебмастере.
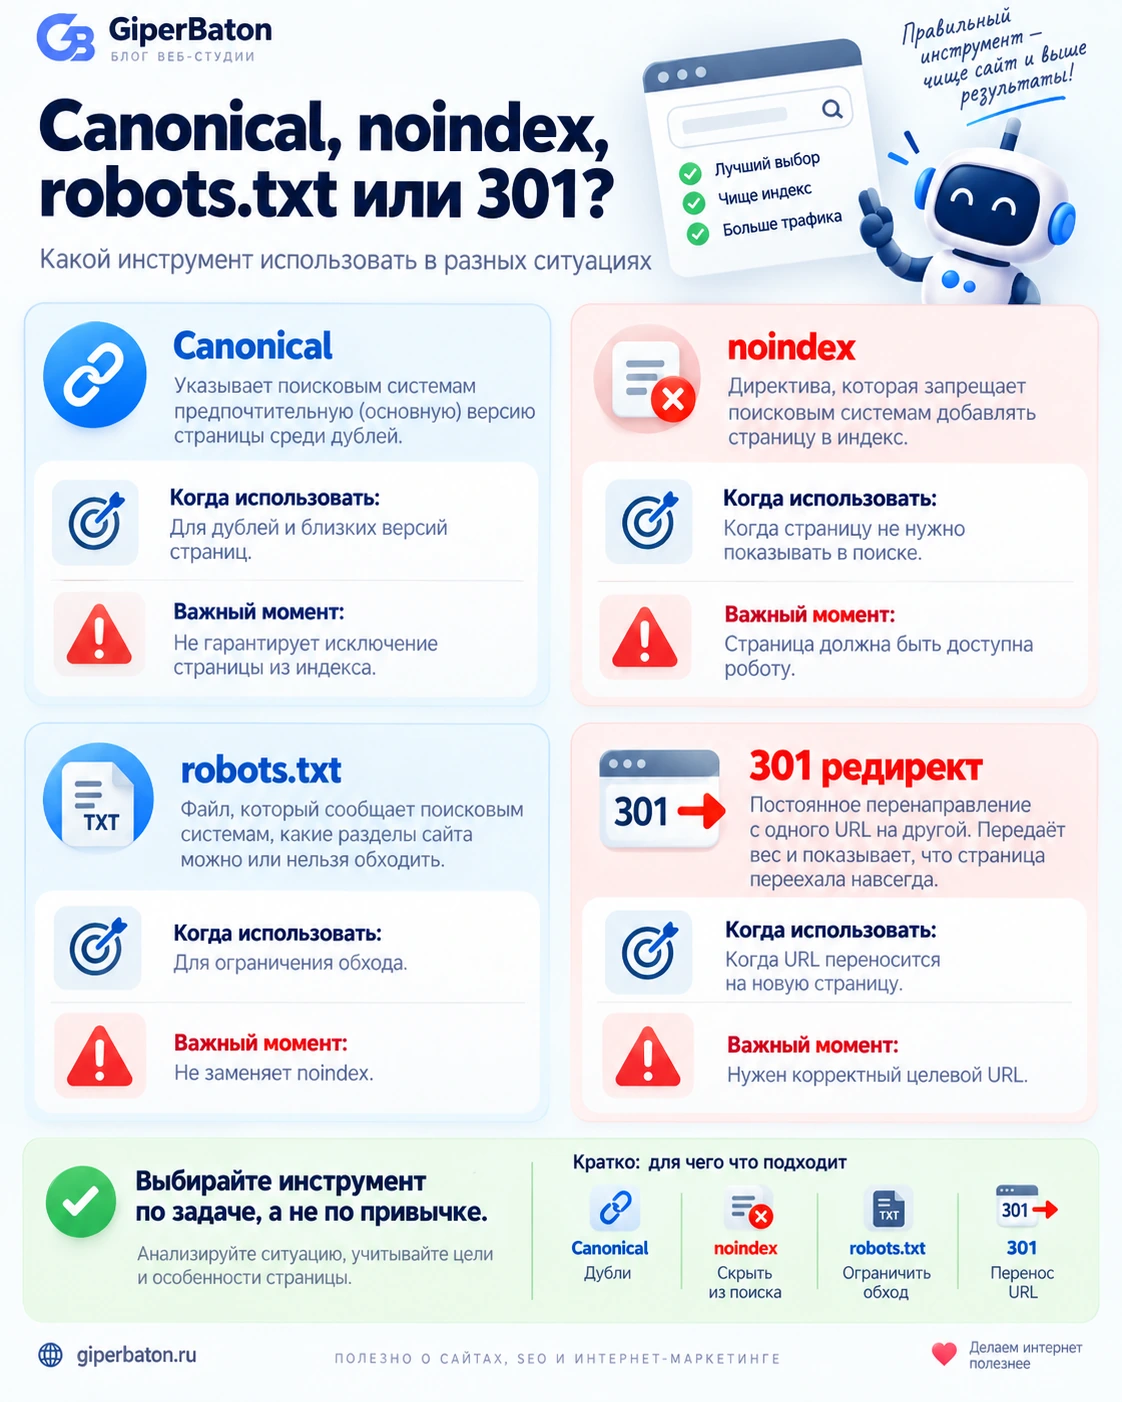
Доработать, объединить, закрыть или оставить? Таблица решений
Правильная цель - не «вернуть в индекс все», а выбрать действие по ценности конкретного URL.
| Что выяснили | Решение | Почему |
|---|---|---|
| Важная услуга, категория или статья; спрос есть; содержание слабое | Доработать | Страница должна самостоятельно отвечать на запрос и быть доступна роботу. |
| Два URL дают практически одинаковый ответ | Объединить / указать канонический URL | Нет необходимости конкурировать копиями одной страницы. |
| Служебный поиск, оформление заказа, технические параметры | Исключить из поиска | Такие адреса не предназначены для органической выдачи. |
| Материал удален и полноценной замены нет | 404 или 410 | Не нужно оставлять несуществующую страницу с ответом 200. |
| Материал перенесен на эквивалентный новый URL | 301-редирект | Посетители и поисковик получают актуальный адрес вместо старого. |
| Узкая страница полезна клиентам, но спрос минимален | Оставить и наблюдать | Нельзя удалять полезный контент только из-за одной причины исключения. |
Осторожно с canonical: не направляйте все исключенные страницы на главную, категорию или другую «сильную» страницу. Этот механизм предназначен для одинаковых или очень похожих документов, а не для любых URL, которые не попали в поиск.
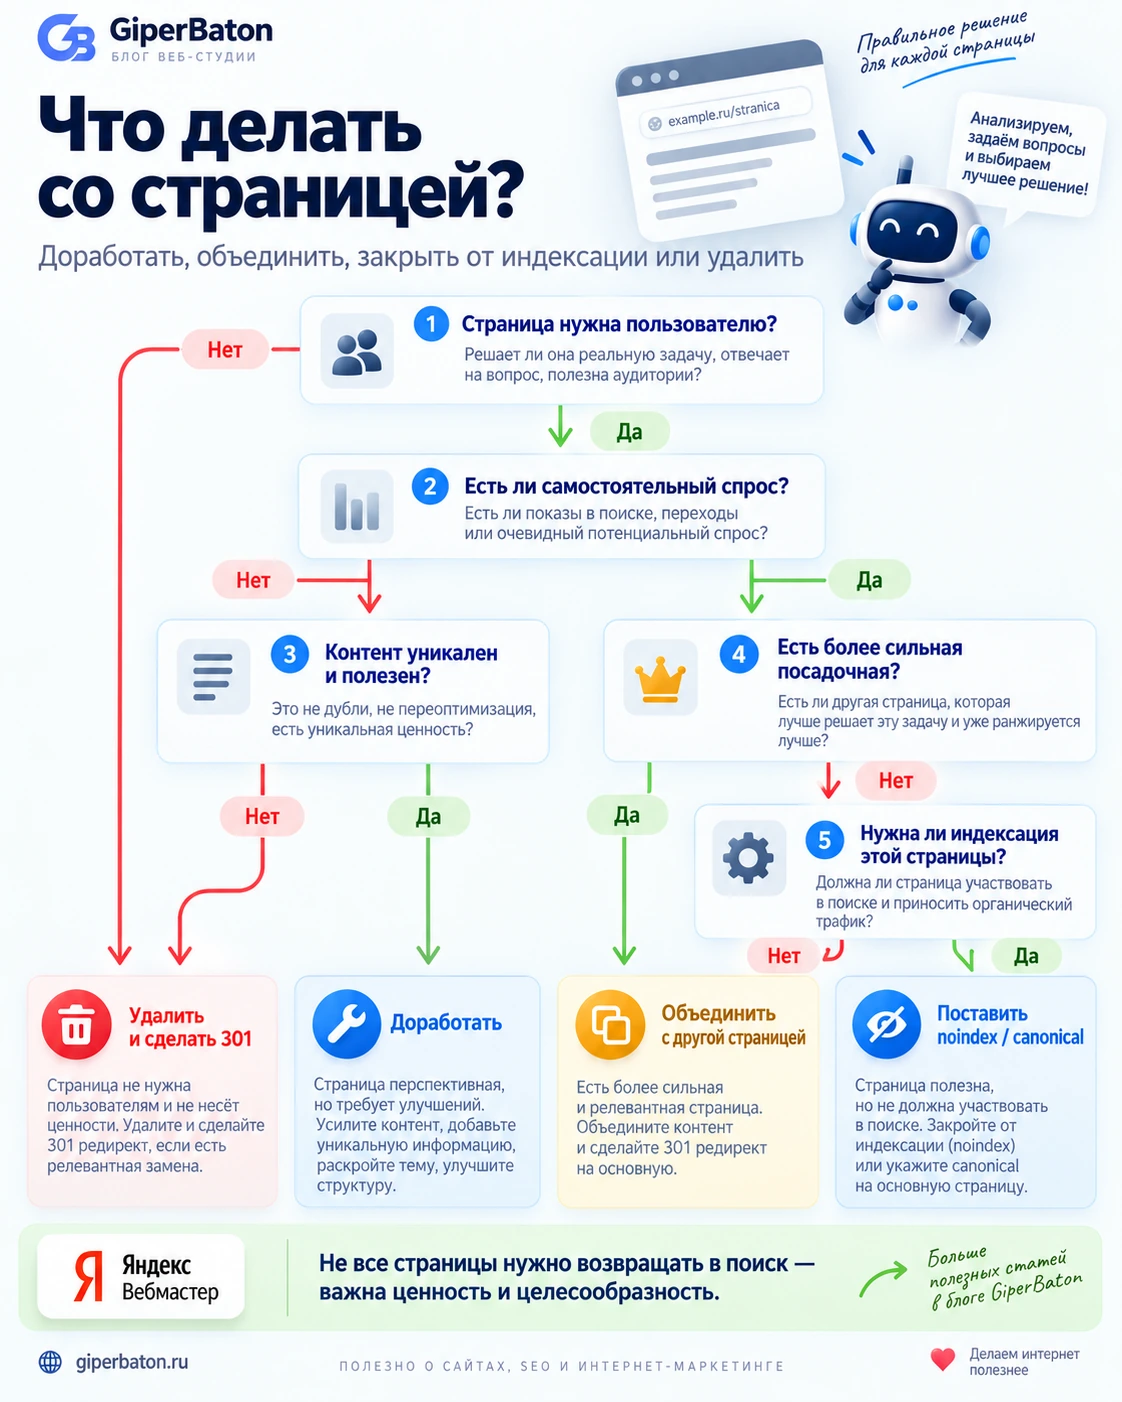
Как исправлять маловостребованные страницы разных типов
| Тип страницы | Что проверить | Что изменить |
|---|---|---|
| Услуга | Отдельный интент, география, реальное предложение, цена, условия. | Уточнить сценарий клиента, добавить состав работ, факты, примеры и ответы на возражения. |
| Статья блога | Попадает ли заголовок и структура в информационный запрос, не перекрывает ли другую статью. | Перестроить материал под вопрос, добавить оригинальные иллюстрации, сравнения, процедуры и ограничения. |
| Городская страница | Существует ли услуга в регионе, есть ли спрос и локальная информация. | Добавить реальные условия работы, районы, сроки и региональные доказательства либо отказаться от лишнего дубля. |
| Категория магазина | Наполнение, товарный выбор, названия и актуальность ассортимента. | Улучшить ассортимент и структуру выбора; сделать понятные фильтры и характеристики. |
| Фильтр / сортировка | Есть ли самостоятельный спрос на комбинацию; не дублирует ли она категорию. | Оставить индексируемыми полезные посадочные комбинации, убрать технические дубли. |
| Карточка товара | Видимость характеристик роботу, наличие товара, совпадение описаний. | Вывести содержимое в HTML, добавить существенные параметры, совместимость, фото и информацию о наличии. |
| Архив / акция | Осталась ли у URL информационная или коммерческая ценность. | Обновить в справочный материал, перенаправить на эквивалентную актуальную страницу или удалить. |
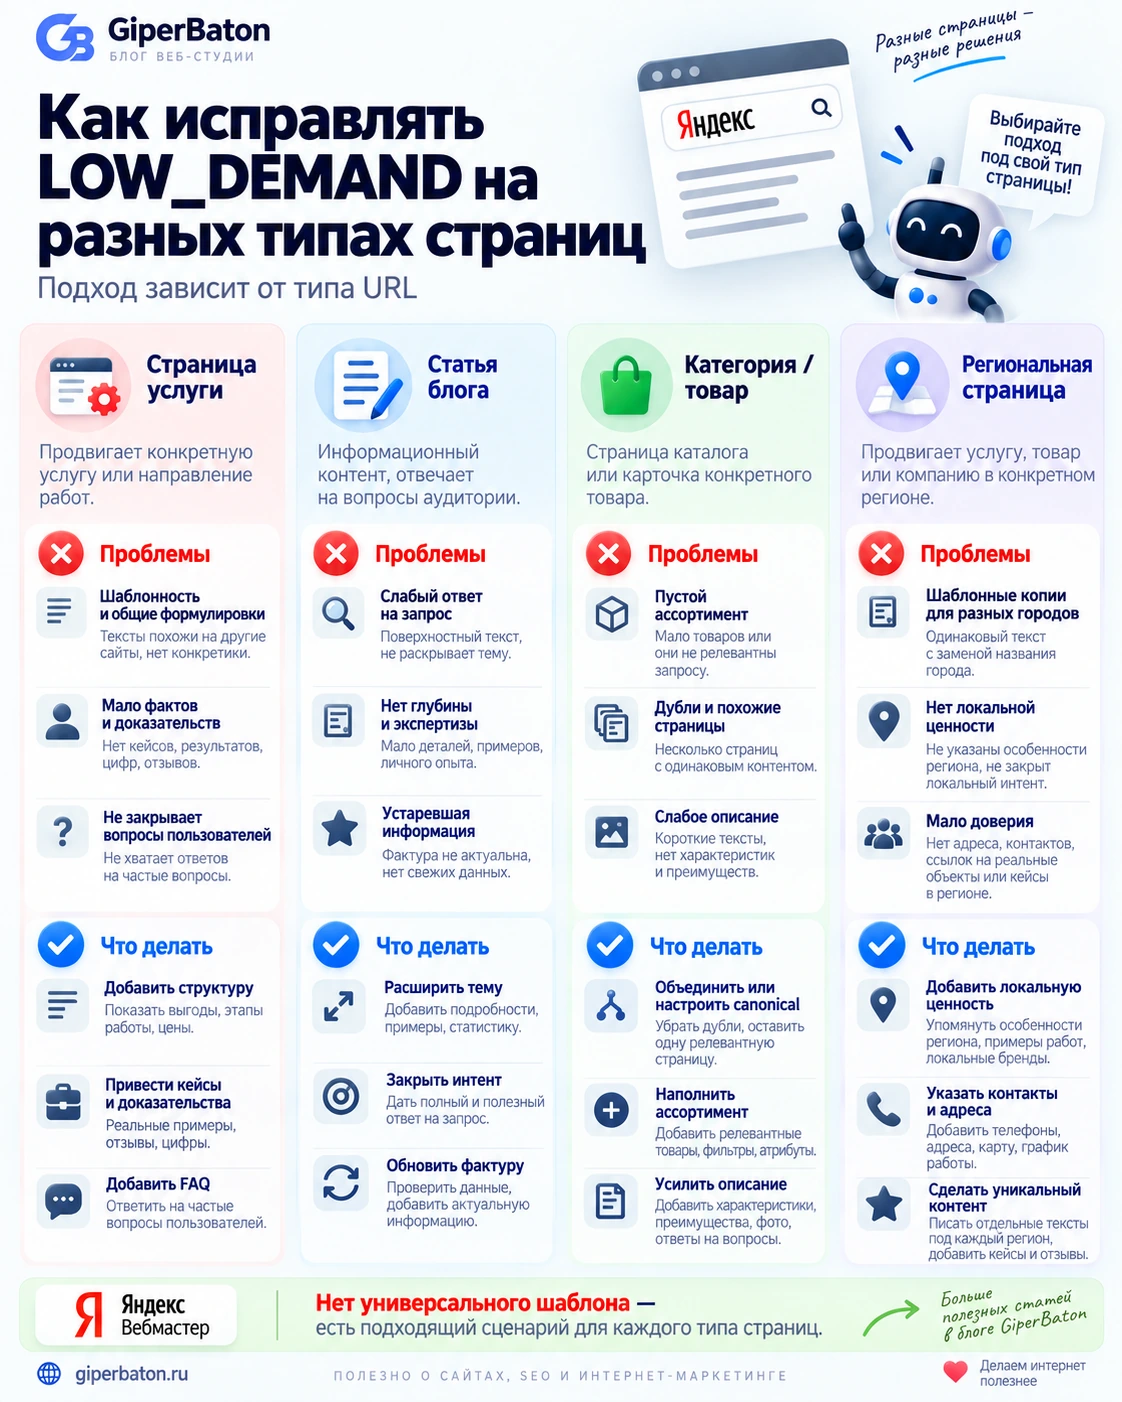
Примеры: какой была страница и что в ней исправить
Ниже - условные примеры для объяснения методики, а не отчеты о результатах конкретных проектов.
Пример 1. Страница услуги: текст есть, полезного ответа нет
До: «Устраняем плесень быстро и качественно. Используем современное оборудование. Звоните». По таким формулировкам невозможно понять, какие поверхности обрабатывают, устраняют ли источник сырости и от чего зависит цена.
После: отдельные блоки о диагностике причины сырости, различиях обработки стен и швов, этапах работ, ограничениях метода, условиях подготовки, цене или способе расчета и реальных примерах. Страница отвечает на вопросы человека, ищущего конкретную услугу.
Пример 2. Десятки городов, но содержание почти не меняется
До: шаблон «Услуга в [город]» размножен на множество URL; меняется лишь географическое название. Нет реального регионального предложения.
После: страницы оставлены только под обоснованные регионы и дополнены проверяемой локальной информацией: условиями выезда, территорией обслуживания, сроками, примерами и контактами. Остальные дубли объединены там, где это уместно.
Пример 3. Статья подробно написана, но отвечает не на тот запрос
До: публикация «Все о выборе кондиционера» преимущественно рассказывает историю технологии, хотя пользователи ищут различия инверторных моделей, расчет мощности и ошибки выбора.
После: ответ в первых абзацах, понятные критерии подбора, таблица для помещений, примеры расчета, объяснение компромиссов и FAQ. Вопрос пользователя стал центром структуры.
Пример 4. Основной контент невидим в исходном HTML
До: сервер возвращает только контейнер <div id="app"></div>, а данные товара подгружаются после выполнения JavaScript. В браузере все выглядит заполненным, но робот может получить пустую основу страницы.
После: значимые товарные данные доступны в HTML-ответе либо в корректно реализованной серверной отрисовке. Затем проверяется именно версия, доступная роботу, а не только красивый экран браузера.
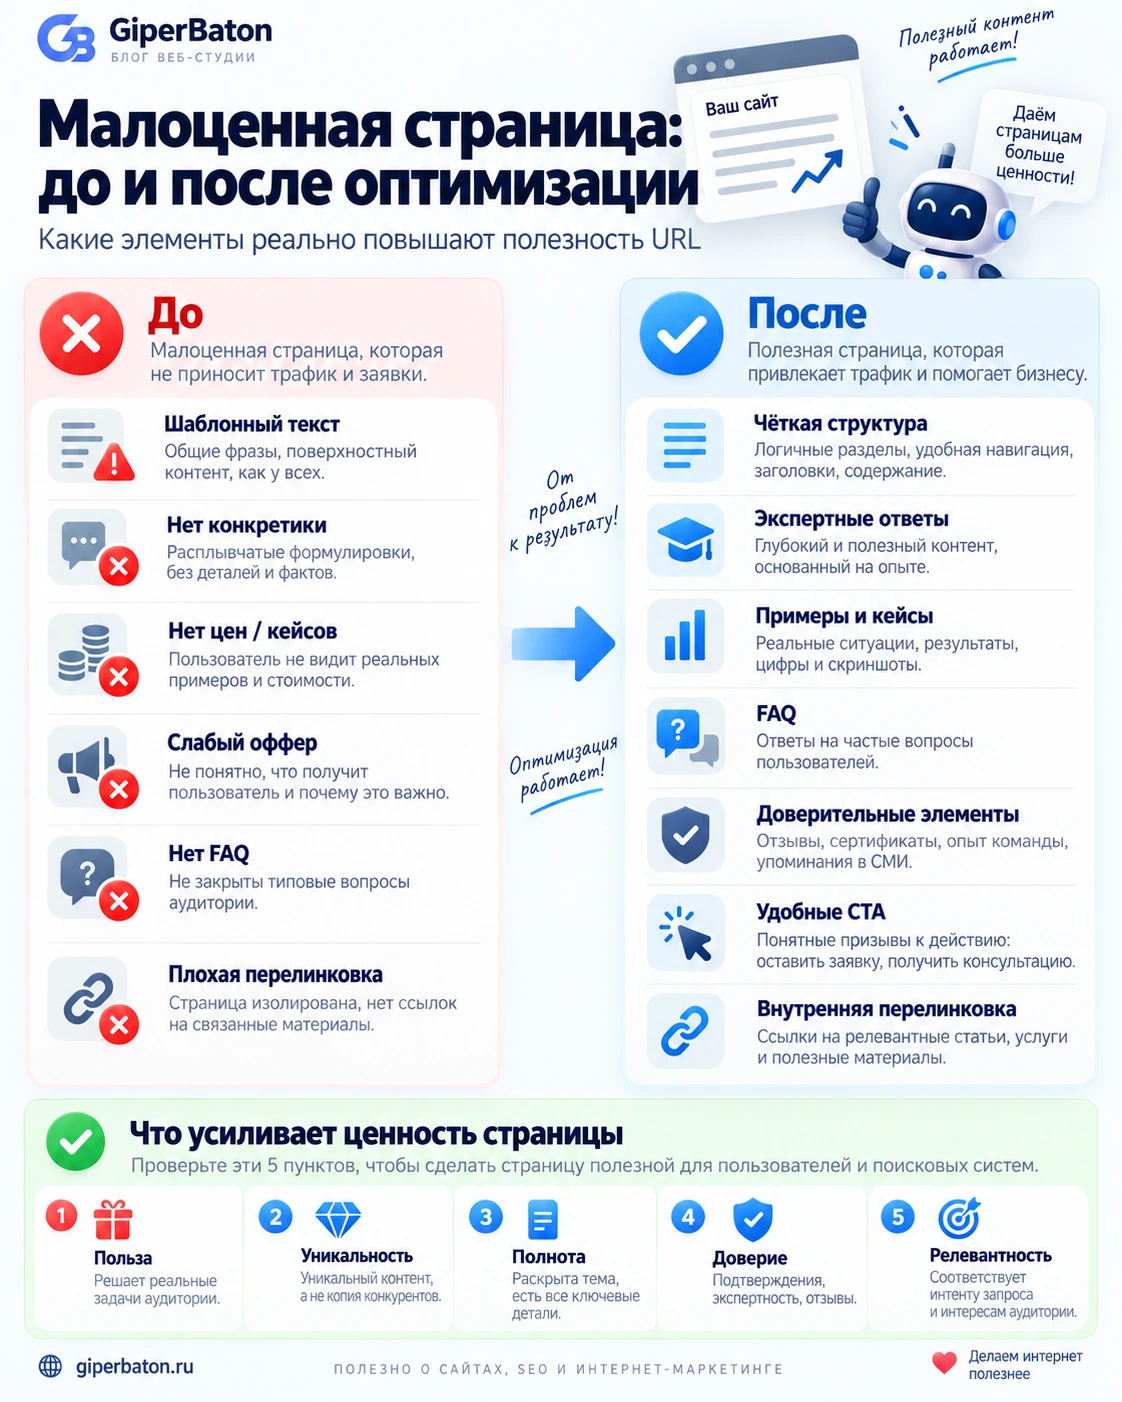
Технические решения: canonical, noindex, robots.txt и редиректы
Эти инструменты помогают управлять адресами, которые действительно не должны участвовать в поиске отдельно. Они не делают слабый контент полезным автоматически.
1. Canonical для настоящих дублей
Если несколько URL показывают одинаковый или почти одинаковый материал, на дублирующей версии можно указать предпочтительный адрес:
<link rel="canonical" href="https://example.ru/catalog/divany/">Проверьте, что целевой URL существует, доступен роботу, индексируем и действительно соответствует содержимому дубликата.
2. Noindex для страницы, которая не должна быть в поиске
<meta name="robots" content="noindex">Это уместно, например, для вспомогательного HTML-раздела без самостоятельной поисковой задачи. Чтобы робот увидел метатег, он должен иметь возможность запросить страницу. Не перекрывайте ее одновременно правилом Disallow до того, как робот обработает запрет, если рассчитываете именно на noindex.
3. Robots.txt для технических разделов
User-agent: Yandex
Disallow: /search/
Disallow: /cart/
Это лишь пример синтаксиса: реальные маршруты и необходимость запрета зависят от сайта. Disallow ограничивает обход. Перед массовым изменением проверьте, какие полезные URL попадают под правило.
4. Редирект или корректный HTTP-статус
Если старый документ перенесен на равнозначный новый адрес, используйте постоянное перенаправление 301. Если страница больше не существует и равноценной замены нет, корректны 404 или 410. Не перенаправляйте каждую удаленную статью на главную: такое поведение не решает задачу пользователя.
Не нужно массово закрывать LOW_DEMAND в robots.txt. Сначала разделите коммерчески важные, дублирующие и технические URL. Иначе можно закрыть от робота страницы, которые стоило доработать.
Как вернуть исправленную страницу в поиск Яндекса
- Устраните причину. Исправьте HTML, содержание, дубли или внутреннюю структуру - в зависимости от диагностики.
- Проверьте результат. Откройте страницу как пользователь и проверьте HTTP-ответ и индексируемость в Яндекс Вебмастере.
- Проверьте sitemap.xml. В карте сайта должны быть актуальные страницы, которые вы действительно хотите видеть в поиске.
- Отправьте приоритетные URL на переобход: «Индексирование» → «Переобход страниц».
- Добавьте важные адреса в мониторинг и проследите за изменениями статуса, датой обхода, показами и кликами.
В документации Яндекса указано, что обработка заявки на переобход и обновление данных происходят не мгновенно. Статус «Заявка обработана» означает, что робот посетил URL, но не гарантирует его включение в поиск. Если основная проблема - отсутствие полезного ответа или спроса, повторный обход сам по себе ничего не исправит.
Как оценить результат: смотрите не только на исчезновение отметки LOW_DEMAND, но и на то, появилась ли приоритетная страница в поиске, начала ли получать показы по релевантным запросам и приводить целевых посетителей.
10 ошибок, из-за которых ситуация с LOW_DEMAND не улучшается
- Массово отправлять URL на переобход без изменений на страницах.
- Увеличивать текст до заданного числа символов, не добавляя полезного ответа.
- Менять только title и description, оставляя основное содержимое прежним.
- Ставить canonical на главную для любых исключенных страниц.
- Создавать десятки страниц под микрозапросы, которые фактически выражают одну потребность.
- Копировать один региональный шаблон, меняя лишь название города.
- Игнорировать видимость контента в HTML, ориентируясь только на браузерную версию.
- Удалять полезные узкие страницы лишь потому, что Вордстат показывает мало запросов.
- Закрывать всю группу URL в robots.txt, не отделив технические от ценных.
- Оценивать успех по проценту индексирования, а не по присутствию ключевых посадочных и росту целевого трафика.
Чек-лист проверки малоценной страницы и план действий на 30 дней
Чек-лист одной приоритетной страницы
- ☐ URL действительно должен привлекать посетителей из поиска.
- ☐ Страница доступна, отдает ожидаемый HTTP-ответ и не закрыта от индексации.
- ☐ Основное содержимое видно роботу, а не только браузеру после загрузки скриптов.
- ☐ Нет дубликата или конкурирующей страницы с тем же назначением.
- ☐ Есть понятная группа реальных запросов и соответствующий интент.
- ☐ H1, title и структура точно описывают то, что есть на странице.
- ☐ Контент решает задачу посетителя лучше, чем общая рекламная заготовка.
- ☐ На URL ведут подходящие внутренние ссылки.
- ☐ Указан правильный canonical; карта сайта не содержит противоречий.
- ☐ После изменений зафиксированы дата переобхода и контрольные метрики.
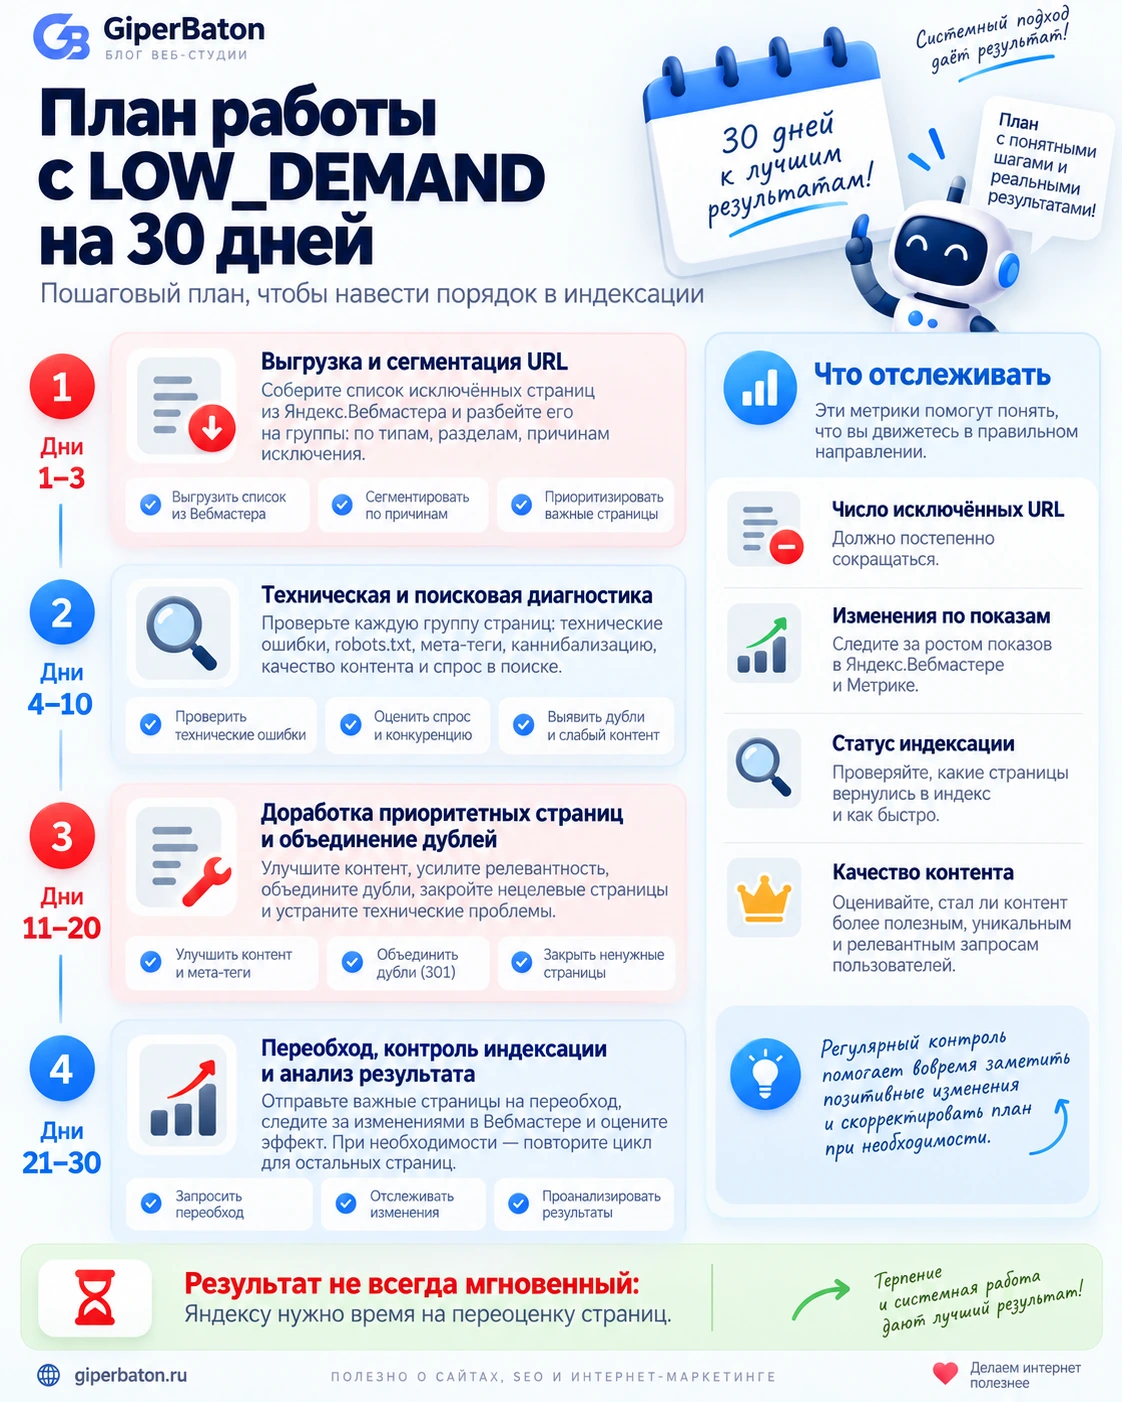
| Период | Что делаем | Что получаем |
|---|---|---|
| Дни 1–3 | Экспортируем LOW_DEMAND, группируем URL, выделяем страницы с потенциальным трафиком и выручкой. | Список приоритетов вместо бесконечного перечня исключений. |
| Дни 4–10 | Проверяем шаблоны, HTML, дубли, интенты и внутренние ссылки. Выбираем корректные решения по группам. | Подтвержденные причины и задания на исправление. |
| Дни 11–20 | Внедряем изменения, перепроверяем страницы и отправляем приоритетные URL на переобход. | Технически и содержательно исправленные страницы. |
| Дни 21–30 | Сравниваем статусы, показы, клики и ошибки. Повторно анализируем страницы без изменений. | Понимание, какие гипотезы подтвердились и что делать дальше. |
Это рабочий график проверки, а не обещание, что через 30 дней все URL окажутся в выдаче. Индексация и оценка востребованности зависят от алгоритмов поисковой системы.
Частые вопросы о статусе «Малоценная или маловостребованная страница»
Можно ли вернуть страницу в поиск только через «Переобход страниц»?
Иногда статус меняется после повторной проверки, но без устранения причины переобход не гарантирует результата. Сначала исправьте обнаруженные проблемы.
Нужно ли переписывать все страницы со статусом LOW_DEMAND?
Нет. Часть URL - нормальные технические дубли и служебные адреса. Дорабатывать стоит те страницы, которым действительно требуется самостоятельная поисковая видимость.
Если статья уникальная на 100 %, почему она малоценная?
Формальная уникальность текста не равна полезности. Страница может не отвечать на запрос, повторять смысл другой публикации или не отдавать важное содержимое роботу.
Плохая ли это отметка для нового сайта?
Не обязательно. Оцените, какие URL исключены, прошел ли их обход, нет ли дублей, пустых шаблонов и неверного сопоставления страниц со спросом. Не делайте вывод по одному общему счетчику.
Можно ли продвигать страницу по низкочастотному запросу?
Да, если она решает самостоятельную задачу и полезна посетителям. Низкая частота запроса не равна автоматически статусу LOW_DEMAND; алгоритм учитывает больше факторов.
Яндекс пишет LOW_DEMAND, а страница прекрасно работает - это ошибка?
Работающая страница не обязательно должна участвовать в поиске. Проверьте, видит ли ее робот, нужен ли отдельный результат по этой теме, не предпочитает ли Яндекс другой URL. Без такой проверки нельзя уверенно назвать статус ошибочным.
Через сколько дней после исправления страница вернется в поиск?
Гарантированного срока нет. Переобход может обновить данные о URL, но окончательное решение о включении в поиск принимает алгоритм. Контролируйте повторный обход и динамику запросов в течение последующих недель.
Стоит ли писать в поддержку Яндекса?
После технической проверки это может быть полезно, если из поиска пропали страницы, которые раньше занимали хорошие позиции, а исключение сопровождалось заметным падением органического трафика. Подготовьте конкретные URL, даты и результаты проверок.
Официальные материалы и дополнительные статьи
Для перепроверки статусов и рекомендаций используйте документацию Яндекса:
- Яндекс: «Малоценные или маловостребованные страницы» - официальное объяснение причины исключения.
-
Яндекс: «Страницы в поиске» - значения статусов, включая
LOW_DEMAND. - Яндекс: «Почему страницы исключены из поиска» - разбор других причин исключения.
- Яндекс: «Переобход страниц» - как сообщить роботу об обновлениях.
В блоге GiperBaton есть также материалы о поисковой видимости в других системах. Например, в статье «Генеративный ИИ в Google Search Console - что показывает новый отчет» разбираем другой класс поисковых данных; его показатели нельзя смешивать со статусами индексирования Яндекса.