
llms.txt - текстовый файл с описанием сайта и ссылками на полезные материалы, оформленный в Markdown. Его могут использовать ИИ-агенты и приложения, поддерживающие этот подход, чтобы находить нужную информацию. [1]
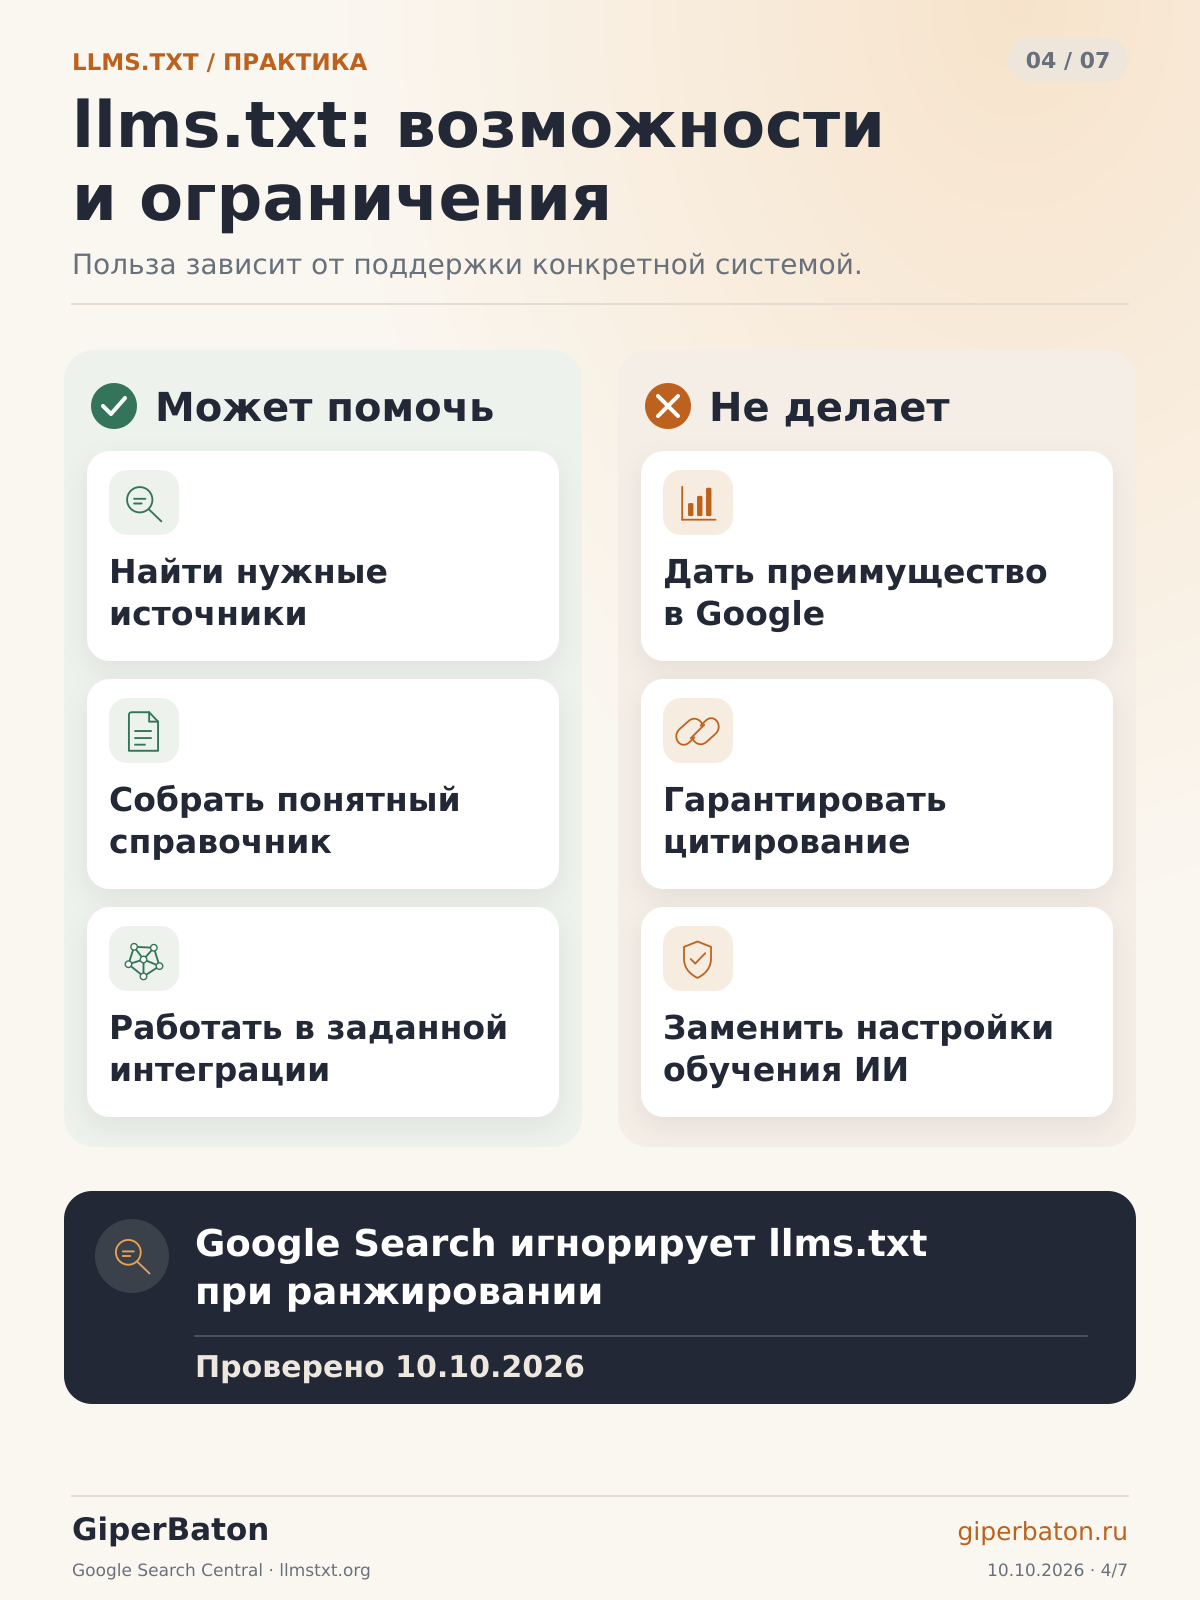
Для продвижения в Google сам файл преимуществ не дает: по официальной позиции поисковика, llms.txt игнорируется и не влияет на видимость и ранжирование, включая генеративные функции поиска. [3]
У владельца сайта возникает закономерный вопрос: если пользователи все чаще обращаются к ИИ, можно ли подготовить для него отдельную инструкцию о компании? llms.txt предлагает удобный способ собрать такую справочную информацию. Практическая ценность появляется тогда, когда понятно, какой инструмент прочитает файл и какую задачу он с его помощью решит.
Разберем, что стоит включать в llms.txt, как разместить его на сайте и по каким признакам оценивать результат. Отдельно рассмотрим ожидания, из-за которых обычная техническая задача превращается в обещание «продвижения во всех нейросетях».
Что такое llms.txt простыми словами
Представьте сайт компании: десятки услуг, кейсы, статьи, разные регионы, старые акции и несколько вариантов навигации. Чтобы ответить на конкретный вопрос, помощнику нужно найти подходящие страницы и разобраться, какие сведения относятся к текущему предложению.
В llms.txt можно собрать короткое описание компании и осмысленный список источников: здесь находится состав услуги, здесь - порядок работы, здесь - подробный разбор задачи. Для человека это похоже на справочный лист, который дают новому сотруднику перед знакомством с проектом.
Например, при вопросе о разработке интернет-магазина полезно направить помощника к странице этой услуги, требованиям к каталогу и подходящим кейсам. Ссылка на случайную новость о запуске студии почти ничего не добавит к ответу.
Сам файл не содержит программу, которая запускается на сервере. Он становится доступным ресурсом, который внешнее приложение может запросить. Публикация также не означает, что информация автоматически загрузилась в память всех моделей.
По состоянию на дату подготовки статьи опубликована версия 2 предложения llms.txt, обновленная в августе 2026 года. Это развивающееся соглашение об организации информации для агентов. [2]
Кто и как использует файл
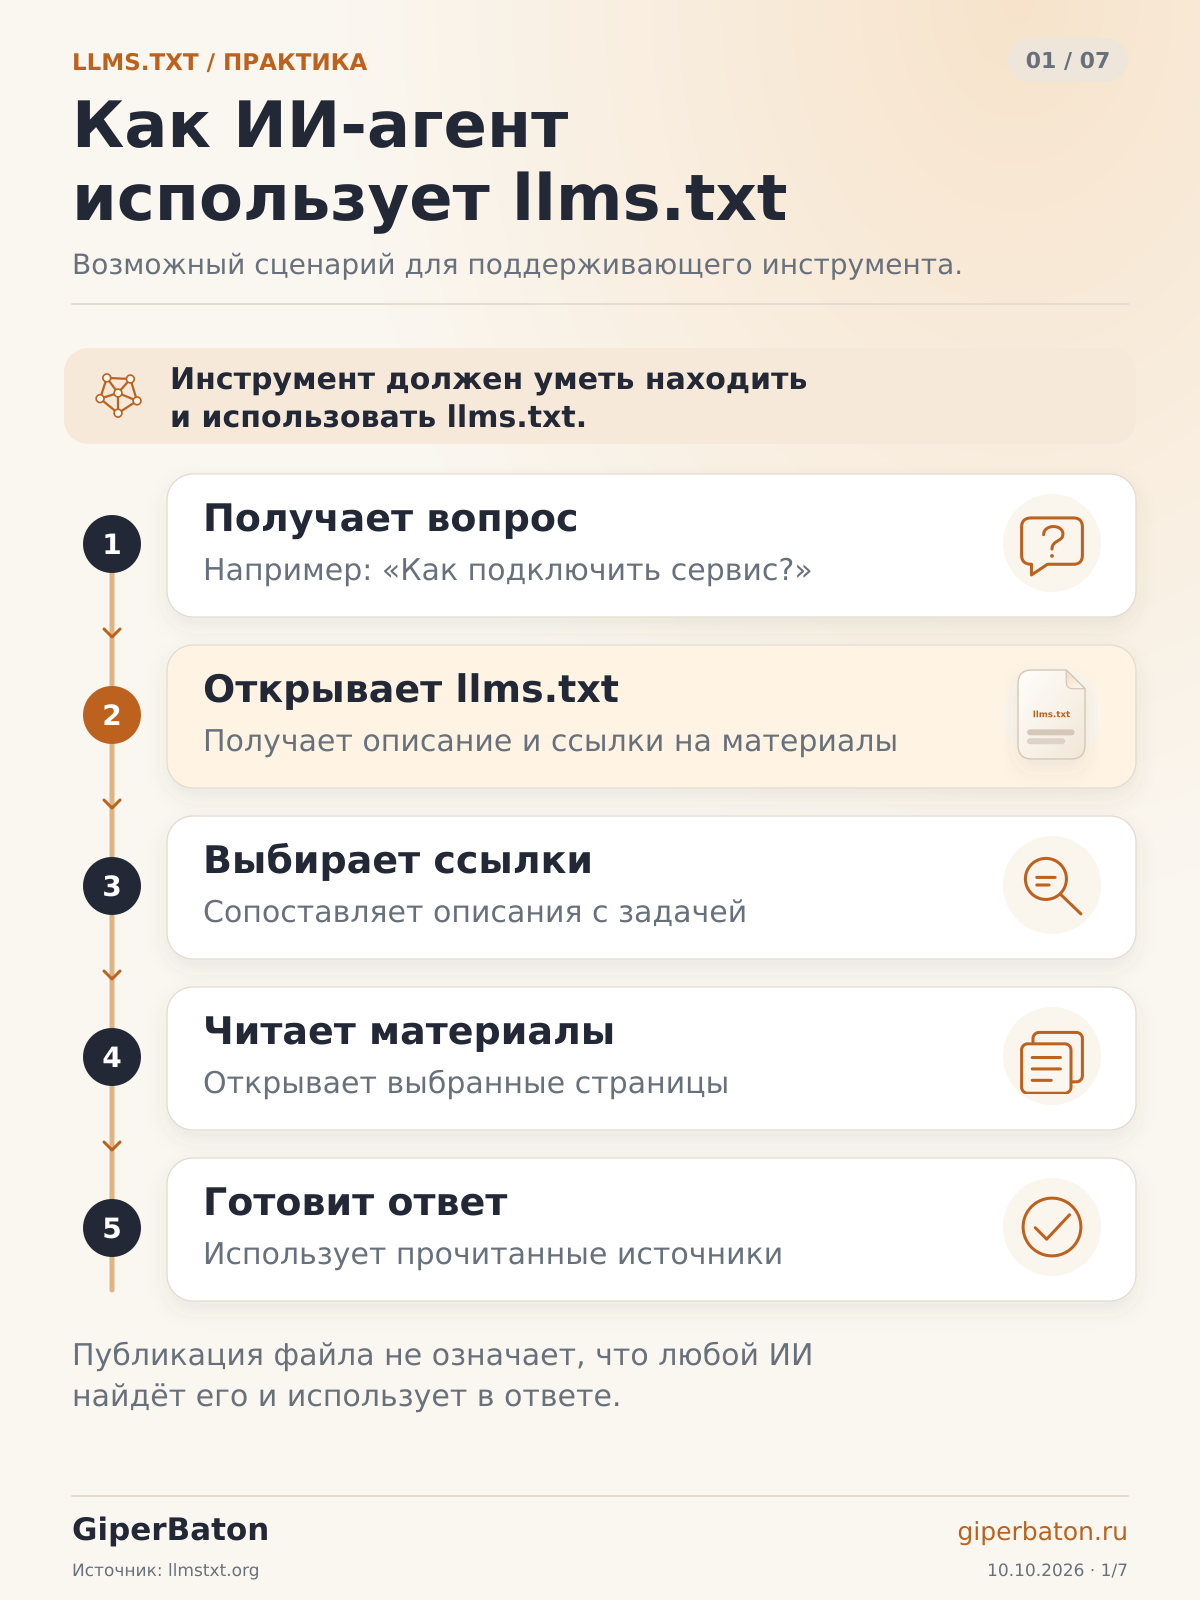
Слово «поддержка» стоит уточнять. Платформа может создавать llms.txt, агент - читать его, а диагностический инструмент - проверять доступность. Эти возможности подтверждают разные вещи.
Платформы документации
Например, Mintlify автоматически формирует llms.txt со ссылками на страницы документации и предоставляет их Markdown-версии. Платформа также поддерживает llms-full.txt с полными текстами. [5]
Агенты с инструментами чтения
Команда LangChain описала MCPDoc: инструмент сообщает агенту адреса llms.txt и позволяет получать их содержимое. Это конкретный пример использования индекса при работе с документацией. В своем эксперименте команда также показала, что один доступ к документам еще не обеспечивает качественное выполнение задачи. [4]
Проверки доступности сайта для агентов
В документации Chrome Lighthouse есть проверка llms.txt в категории Agentic Browsing. Серверная ошибка при загрузке отмечается аудитом. Если файл отсутствует и сервер отвечает 404, проверка получает статус N/A: размещение остается необязательным. [6]
Как оценивать заявления о поддержке: наличие файла на сайте известной компании подтверждает его публикацию. Чтобы говорить об использовании, нужны сведения о конкретном инструменте, его настройках и фактическом обращении к содержимому.
Влияет ли llms.txt на SEO и попадание в ответы ИИ
Google Search прямо сообщает, что не использует llms.txt и аналогичные специальные файлы для улучшения видимости сайта. Это относится и к генеративным возможностям поиска. Google допускает поддержку такого файла для других систем, но само его наличие не помогает и не вредит ранжированию. Возможное обнаружение или индексирование текстового URL не придает ему особого статуса. [3]
Поэтому в предложении «создадим llms.txt и выведем сайт в ответы Google» причинная связь не подтверждается документацией поисковика. Проверка этого файла в Lighthouse относится к доступности для агентов и не меняет описанную позицию Google Search.
Для участия страниц в генеративных функциях Google сохраняют значение индексация, возможность показа сниппета и базовая работа над сайтом. [3] Также стоит проверить настройку Search generative AI в Search Console: сайт не должен быть исключен из этих функций. Включение предусмотрено по умолчанию, а дочерний ресурс может наследовать настройку родительского. [11]
У других ИИ-продуктов собственные механизмы получения информации. Для конкретного агента llms.txt может стать удобной точкой входа, если этот агент действительно умеет его находить и читать. Переносить такой результат на все ответы ChatGPT, Claude или другого сервиса оснований нет.
Более широкий план работы с видимостью разобран в статье «Как попасть в ответы ИИ Google» .
Чем llms.txt отличается от robots.txt и sitemap.xml
На одном сайте могут существовать несколько технических файлов. Их имеет смысл сравнивать по задаче, которую каждый решает.
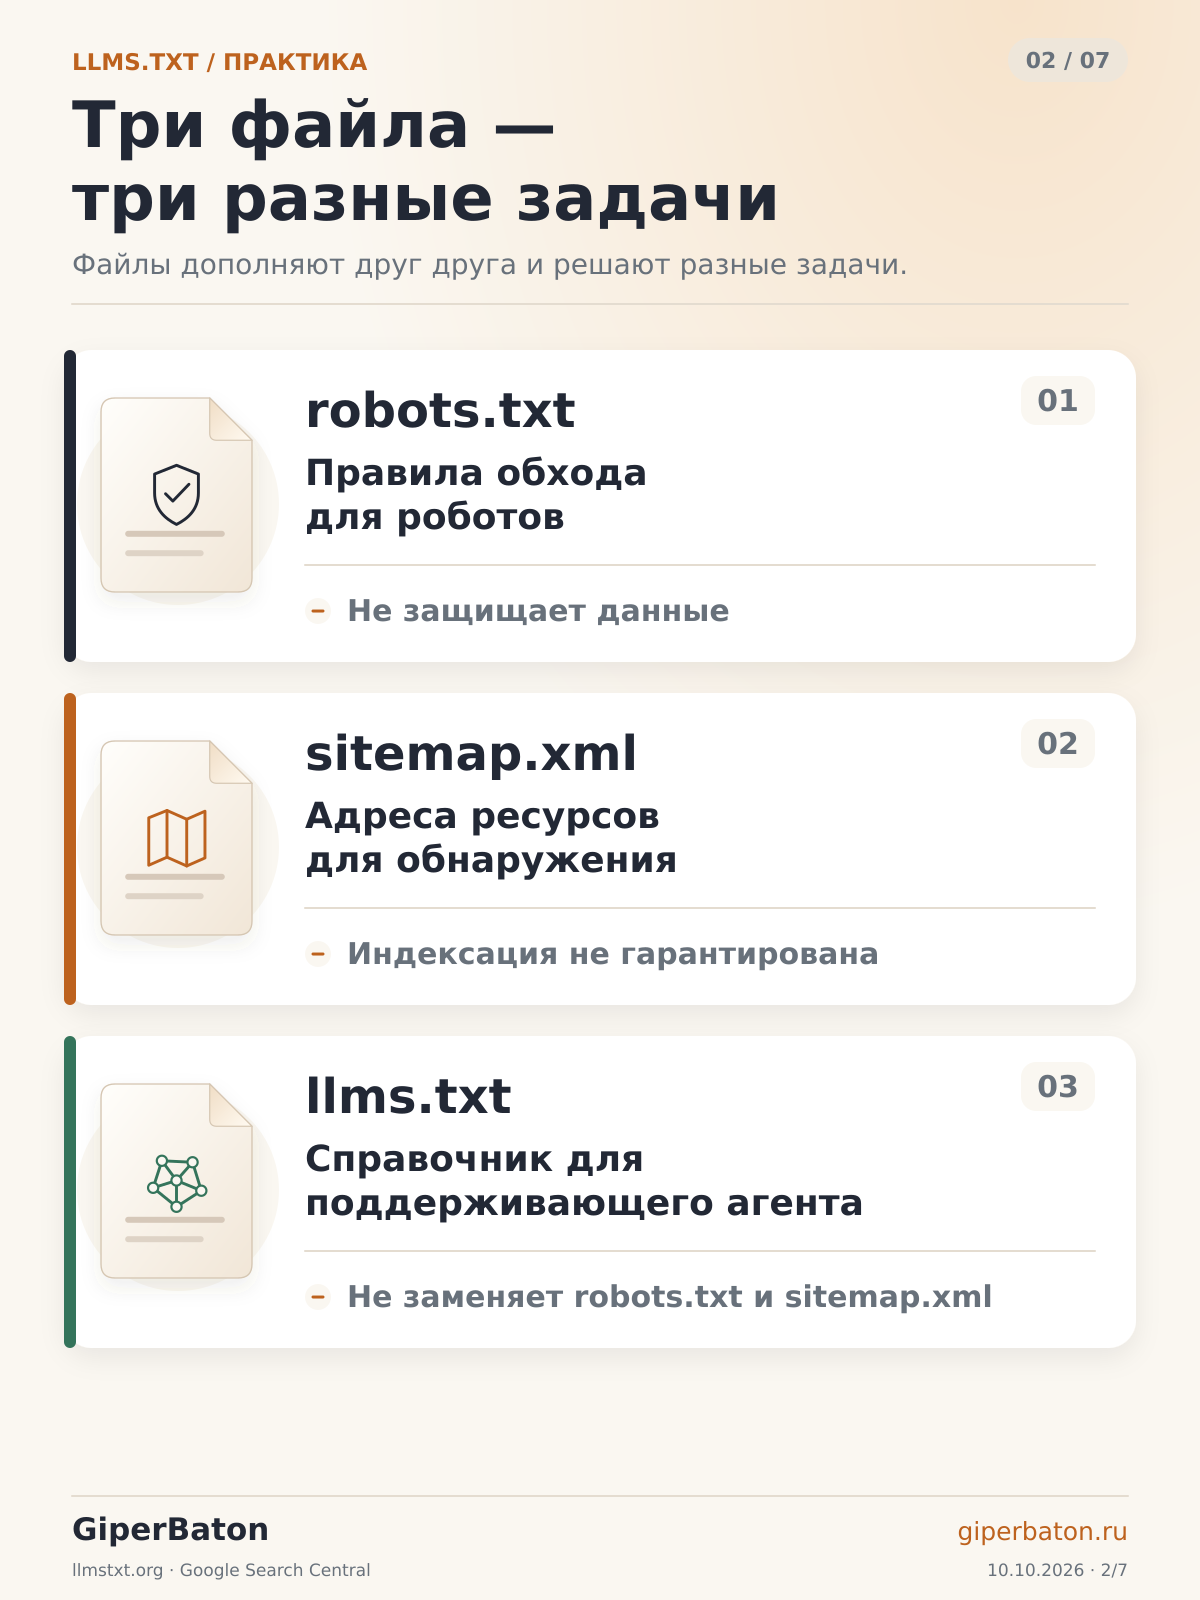
| Файл | Основная задача | Что нужно учитывать |
|---|---|---|
robots.txt |
Задает правила обхода URL для роботов, которые их соблюдают. | Сам по себе не защищает конфиденциальные данные и не гарантирует удаление URL из поиска. [7] |
sitemap.xml |
Сообщает поисковикам об адресах страниц и других ресурсов сайта. | Помогает обнаружению URL, но не гарантирует их обход и индексирование. [8] |
llms.txt |
Предлагает поддерживающим инструментам краткий справочник и ссылки. | Его практическое применение зависит от конкретного потребителя файла. [1] |
llms-full.txt |
В распространенной реализации объединяет полные тексты материалов. | Объем и полезность такой выгрузки нужно оценивать под задачу агента. [5] |
Предположим, страница услуги закрыта от нужного робота, а ее адрес добавили в llms.txt. Само упоминание ссылки не устраняет ограничение доступа. Аналогично, если материал удален, описание в индексе не восстановит его содержимое.
Управление использованием контента для поиска и обучения также требует отдельных настроек. Например, OpenAI разделяет OAI-SearchBot для поиска и GPTBot для обхода контента, который может использоваться при обучении. Эти настройки в robots.txt независимы. Фраза внутри llms.txt о запрете обучения не заменяет документированные механизмы соответствующего сервиса. [9]
Каким сайтам стоит создавать llms.txt
Мы предлагаем оценивать необходимость через сценарий использования. Сначала сформулируйте задачу помощника, затем проверьте, способен ли подготовленный файл облегчить ее выполнение.
| Тип сайта | Возможный сценарий | Наш ориентир |
|---|---|---|
| Документация продукта или API | Помощник ищет способы интеграции, параметры и примеры. | Начать с проверки совместимости используемого агента. |
| База знаний | Нужно связать обзорные материалы с подробными инструкциями. | Подготовить тематический индекс и контрольные вопросы. |
| Корпоративный сайт | Агент уточняет услуги, этапы работы и ограничения. | Рассматривать как небольшую дополнительную задачу. |
| Интернет-магазин | Помощнику нужны правила доставки, возврата и выбора товаров. | Начать со справочных разделов; актуальность цен и остатков решать отдельно. |
| Небольшой лендинг | Вся существенная информация уже находится на одной странице. | Создавать при наличии конкретного потребителя или требования интеграции. |
Для коммерческого сайта хороший предварительный вопрос звучит так: «На какие вопросы о нашей компании помощник должен отвечать точнее?» Список из пяти реальных вопросов полезнее абстрактной цели «стать понятнее искусственному интеллекту».
Например: какие задачи решает услуга, что входит в работу, какие исходные данные нужны от заказчика, в каких регионах действует предложение и где можно посмотреть подходящие проекты. Если ответы отсутствуют на самом сайте, первым этапом становится подготовка этих страниц.
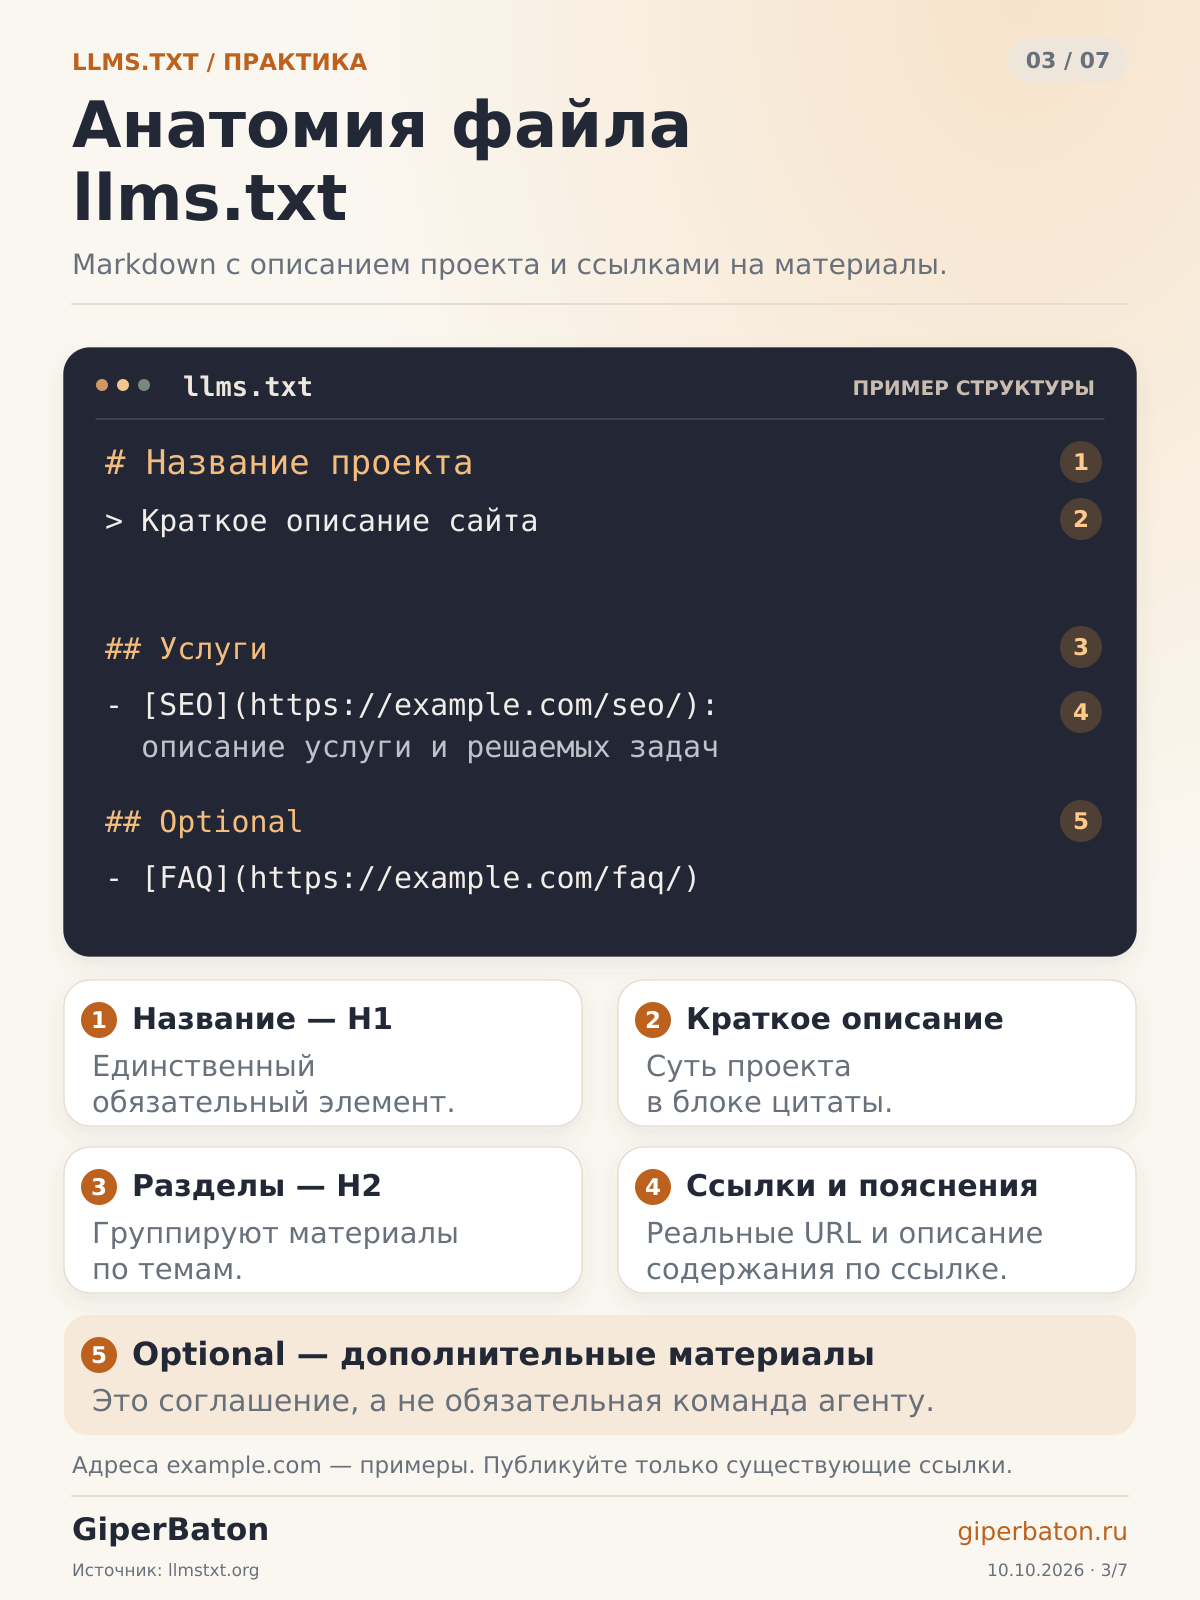
Как составить llms.txt: структура и пример
Формат основан на Markdown: название проекта в заголовке первого
уровня, описание в цитатном блоке, пояснения и разделы со ссылками.
Обязателен только заголовок. Раздел Optional по соглашению
содержит второстепенные материалы.
[1]
Для первого варианта на сайте услуг мы рекомендуем такую редакционную логику:
- Кто вы: название компании и понятное направление деятельности.
- Как читать материалы: где указаны актуальные условия, какие разделы отличаются по назначению.
- Основные услуги: конкретные страницы с коротким пояснением содержания.
- Подтверждающие материалы: кейсы, инструкции и ответы на сложные вопросы.
- Дополнительные сведения: только то, что полезно в выбранном сценарии.
Ниже - учебный пример для GiperBaton. Он показывает структуру файла и не означает, что такой файл уже опубликован на сайте.
# GiperBaton

> Веб-студия: разработка сайтов и SEO-продвижение.

Здесь собраны основные услуги и практические материалы.
Актуальный состав работ и условия указаны на страницах услуг.

## Услуги

- [Аудит сайта](https://giperbaton.ru/uslugi/audit-sayta/): Проверка технического состояния, структуры и поисковой видимости.
- [Продвижение в Google](https://giperbaton.ru/uslugi/prodvizhenie-v-google/): Работа над техническим качеством, контентом и органическим трафиком.
- [Корпоративный сайт](https://giperbaton.ru/uslugi/razrabotka-korporativnogo-sayta/): Проектирование и разработка сайта компании.

## Практические материалы

- [Ответы ИИ Google](https://giperbaton.ru/blog/kak-popast-v-otvety-ii-google/): Технические условия и работа с содержанием страниц.
- [Генеративный ИИ в Search Console](https://giperbaton.ru/blog/generativnyy-ii-google-search-console/): Разбор отчета и интерпретации показателей.
В примере стоят адреса существующих HTML-страниц. Предложение llms.txt
рекомендует ссылки на материалы, удобные для машинного чтения,
например Markdown-версии страниц.
[1]
Если таких версий пока нет, используйте доступные источники
и проверяйте их чтение выбранным инструментом. Дописывать
.md к адресам до появления соответствующих ресурсов
нельзя: расширение в ссылке само по себе не создает страницу.
Описание ссылки должно помогать выбрать материал. Вместо «Лучшая услуга по выгодной цене» напишите, что именно раскрыто на странице: этапы аудита, состав разработки, условия доставки или требования к интеграции.
Нужны ли Markdown-страницы и llms-full.txt
Markdown-версия отдельной страницы позволяет предоставить ее содержимое в простом текстовом виде. При подготовке такой версии сохраняйте смысл, заголовки, списки, таблицы и полезные ссылки. Шапку, меню, повторяющийся футер и элементы интерфейса обычно нет причин включать в справочный текст.
Особенно внимательно проверяйте ограничения и пояснения. Например, если из страницы услуги оставить цену «от 30 000 рублей» и удалить условия расчета, получившаяся выдержка будет вводить в заблуждение. В текстовой версии должны сохраняться сведения, от которых зависит понимание предложения.
llms-full.txt решает другую задачу: в реализации Mintlify он объединяет тексты документации в один ресурс. Это дополнительная форма предоставления контекста. [5]
Для первого эксперимента с корпоративным сайтом мы бы начали с короткого индекса и нескольких качественно подготовленных страниц. Полная выгрузка уместна, когда инструменту действительно требуется большой объем материалов и известны его ограничения.
Если в одном файле смешать все статьи, архивные акции, повторяющиеся описания услуг и региональные версии, вам станет сложнее проверять его актуальность. Лучше заранее определить, какие сведения входят в выгрузку, откуда они берутся и как обновляются.
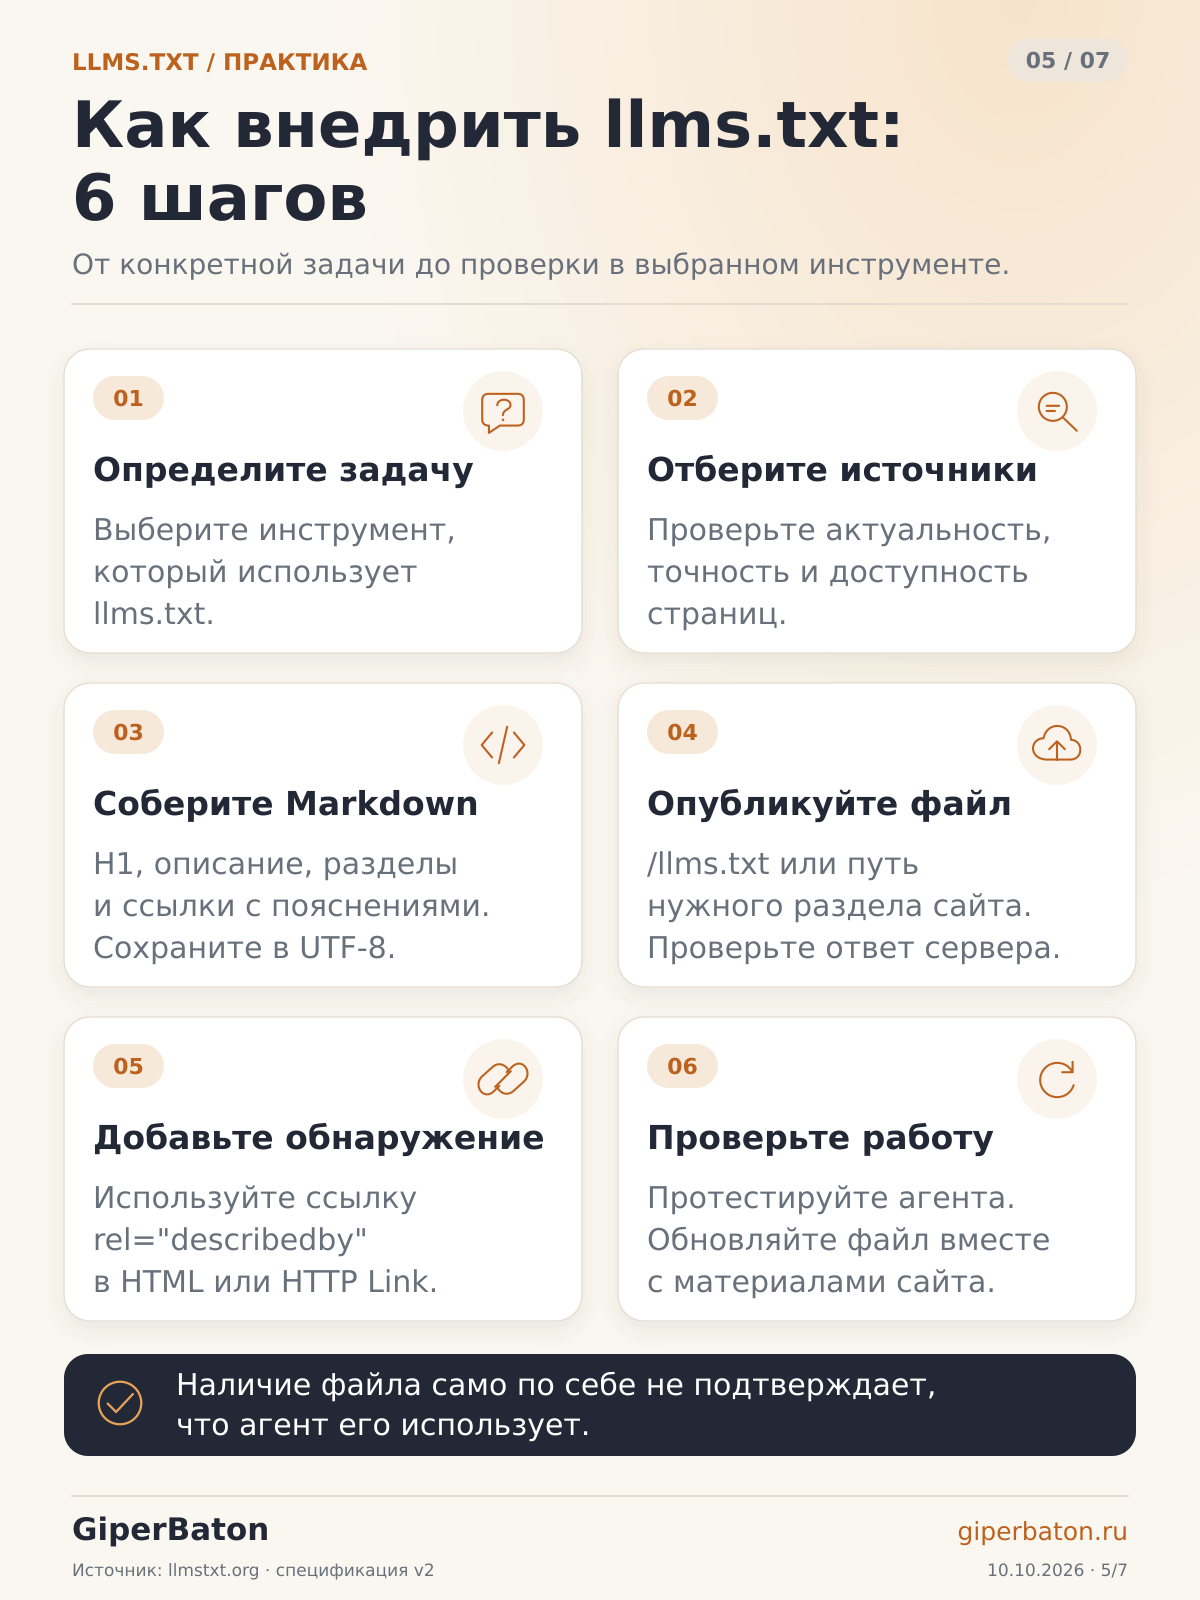
Как внедрить llms.txt на сайте: пошаговый план
Шаг 1. Определите задачу и набор страниц
Запишите, для кого создается индекс: помощник по документации, агент для сравнения услуг, внутренний инструмент команды. Для каждого сценария выберите материалы, которые действительно понадобятся.
Для первой версии небольшого сайта можно взять 10–20 содержательных ссылок. Это рабочий ориентир, который мы предлагаем для удобства проверки, а не требование формата или поисковой системы. Если достаточно пяти страниц, расширять список ради количества не нужно.
Шаг 2. Проверьте исходные сведения
Сверьте названия услуг, содержание страниц, условия работы и регионы. Уберите ссылки на удаленные материалы, дубли и технические адреса. Для обычных страниц используйте актуальные основные URL без рекламных меток.
Не переносите в публичный файл внутренние инструкции, неопубликованные документы и сведения из закрытых разделов. Автоматическая выгрузка должна использовать заранее выбранный набор разрешенных материалов.
Шаг 3. Создайте текстовый ресурс
Сохраните содержимое в UTF-8 под именем llms.txt.
Убедитесь, что редактор не добавил второе расширение и файл
не превратился в llms.txt.txt.
Реализация может быть разной: статический файл, генерация при сборке сайта или обработчик в CMS. Для читателя файла существенны доступность адреса, корректное содержимое и своевременное обновление.
Шаг 4. Выберите адрес с учетом области действия
В версии 2 уточнено: файл может находиться в корне сайта или внутри
раздела. Он описывает страницы под соответствующим путем;
при пересечении областей агенту предлагается использовать
более конкретный файл. Например, /docs/llms.txt
относится к разделу документации.
[2]
Для первой реализации корпоративного сайта удобно начать с адреса:
https://example.com/llms.txt
Если существуют отдельные региональные разделы, следите, чтобы
описания не смешивали города и условия. Файл для подраздела
/spb/, если вы решите его создать, должен описывать
соответствующую часть сайта. Это организация справочной информации
для агента; настройки региональных страниц и навигации сайта
требуют собственной проверки.
Шаг 5. Помогите инструментам обнаружить файл
Версия 2 описывает ссылки обнаружения через HTML-элементы
link или HTTP-заголовок Link.
Отношение describedby указывает на llms.txt,
а alternate с типом text/markdown -
на Markdown-версию страницы.
[2]
Например, в <head> страницы можно разместить:
<link rel="describedby" href="/llms.txt">Для страницы услуги, у которой уже создана собственная Markdown-версия, пример дополнительной ссылки выглядит так:
<link rel="alternate"
      type="text/markdown"
      href="https://example.com/uslugi/audit/index.md">
Во втором примере нужно подставить реальный адрес текстовой версии именно текущей страницы. Одинаковая ссылка на один Markdown-документ во всех шаблонах не решает эту задачу.
Шаг 6. Назначьте порядок обновления
Определите, кто пересматривает индекс при изменении услуг, публикации важных материалов и переносе URL. Если файл создается автоматически, проверьте правила отбора страниц, обработку удалений и обновление кеша.
При разработке корпоративного сайта такую возможность стоит обсудить вместе со структурой контента и CMS. Поддерживать один источник сведений удобнее, чем вручную исправлять условия на странице, в llms.txt и еще в нескольких независимых выгрузках.
Как проверить, что llms.txt работает
Проверку полезно разделить на две части: техническую доступность и пригодность для выбранной задачи.
Проверьте ответ сервера и содержимое
Откройте адрес файла в браузере и посмотрите, что фактически возвращается. Для проверки заголовков и тела ответа можно использовать команду, заменив домен своим:
curl -i https://example.com/llms.txtДля обычного публичного текстового файла практичная конфигурация выглядит так:
HTTP/2 200
Content-Type: text/plain; charset=utf-8
Это пример желаемого ответа. Проверяйте не только статус: сайт может возвращать 200 и одновременно отдавать HTML главной страницы, форму авторизации или сообщение защитного сервиса.
- По адресу приходит актуальный текст llms.txt.
- Кириллица отображается корректно.
- Все ссылки открывают ожидаемые материалы.
- Markdown-версии, если они указаны, действительно существуют.
- У целевого инструмента есть доступ к файлу и связанным страницам.
- После изменения исходных данных обновляется опубликованная версия.
Проверьте ответы конкретного агента
Дайте инструменту с доступом к интернету адрес llms.txt и несколько вопросов. Например:
Используй указанный llms.txt как начальный источник.
Найди страницы, которые позволяют ответить:

1. Какие основные услуги предлагает компания?
2. Где описан состав аудита?
3. Где посмотреть условия разработки корпоративного сайта?
4. Есть ли материал о видимости в ответах ИИ?
5. Каких данных не хватает для точного расчета стоимости?

Открой подходящие страницы и приведи их URL.
Если источник недоступен или ответа нет, сообщи об этом.
Не додумывай условия, цены и результаты.
Оцените точность фактов и ссылки, которыми агент подтверждает ответ. Самоуверенное сообщение «файл успешно изучен» недостаточно, если инструмент не может показать, откуда взяты сведения.
Граница такого теста: явно переданный адрес проверяет, способен ли инструмент использовать файл. Чтобы проверить самостоятельное обнаружение, проведите отдельный запуск без этой подсказки.
Как оценивать результат после внедрения
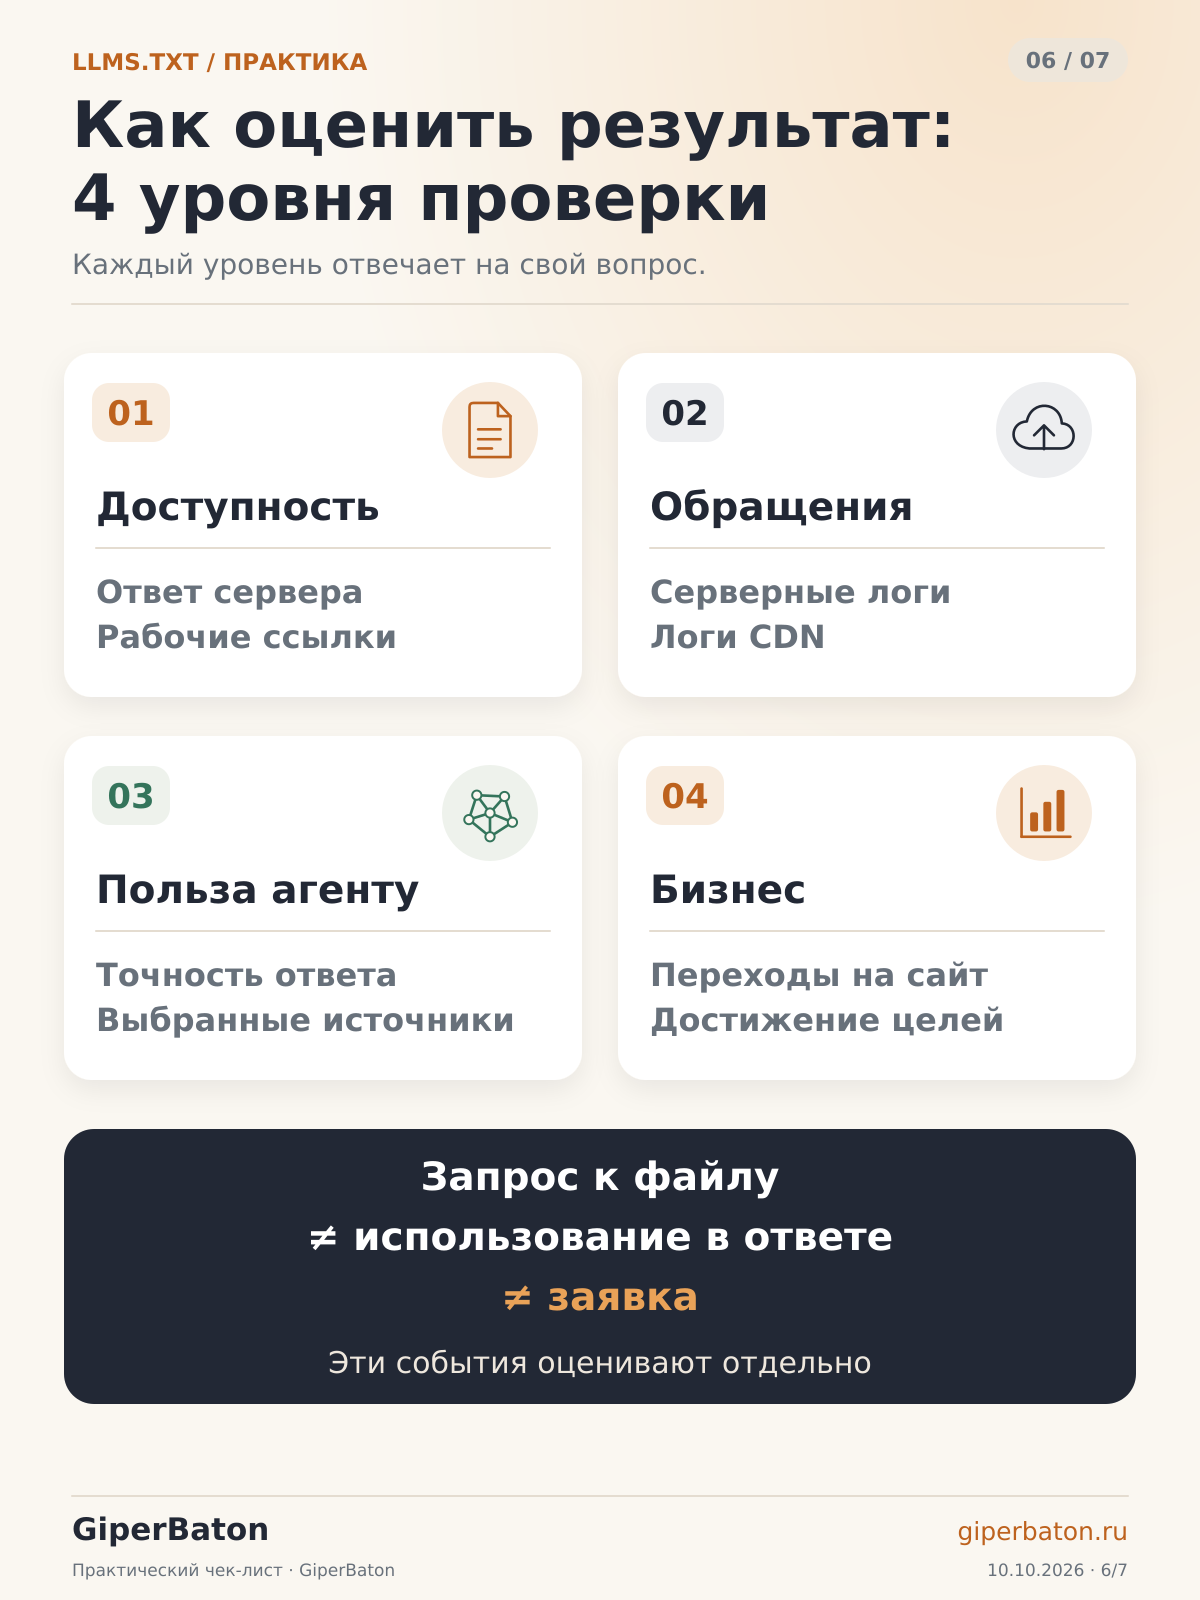
Мы рекомендуем отдельно фиксировать четыре уровня результата. Это поможет не превращать технический факт загрузки в необоснованный вывод о росте продаж.
| Уровень | Что наблюдать | Какой вывод допустим |
|---|---|---|
| Доступность | Ответ сервера, текст, работоспособность ссылок. | Файл опубликован и технически доступен. |
| Обращения | Запросы в журналах сервера и CDN. | Клиенты запрашивали ресурс; дальнейшее использование еще нужно установить. |
| Польза для агента | Точность контрольных ответов, найденные источники и ошибки. | Файл помогает или мешает конкретному инструменту в заданном сценарии. |
| Результат для бизнеса | Переходы, обращения и другие цели в аналитике. | Есть наблюдаемая динамика; ее причины требуют отдельного анализа. |
Один запрос к /llms.txt не показывает, использовала ли
модель сведения в ответе. Название User-Agent тоже не стоит считать
достаточным подтверждением личности клиента. При анализе проверяйте
доступные признаки принадлежности запросов и учитывайте работу CDN:
часть обращений может обслуживаться из кеша без попадания в журнал
основного сервера.
Для сравнения поведения агента используйте одинаковые вопросы и сохраняйте условия запусков. Полезно фиксировать найденные страницы, фактические ошибки и случаи, когда ответ не удалось получить. Запуск с llms.txt и запуск с обычной страницей проверяют конкретную гипотезу удобства навигации.
Что смотреть в Google Search Console
На дату подготовки статьи отдельный отчет Generative AI performance показывает показы ссылок в AI Overviews и AI Mode. Данные можно анализировать по страницам, странам, датам и устройствам. При недостаточном количестве показов отчет может не отображаться. Он не предоставляет отдельную статистику заявок и не является отчетом об использовании llms.txt. [10]
Подробности разобраны в материале про отчет о генеративном ИИ в Google Search Console . Переходы из других ИИ-сервисов можно исследовать по доступным реферерам и UTM-меткам, а обращения - по настроенным целям аналитики.
Если после публикации файла выросли показы, одного совпадения по времени недостаточно для вывода о причине. Одновременно могли измениться страницы, спрос, конкуренты или работа самих сервисов. Для Google дополнительно учитывайте его прямое пояснение о неиспользовании llms.txt. [3]
Восемь ошибок при работе с llms.txt
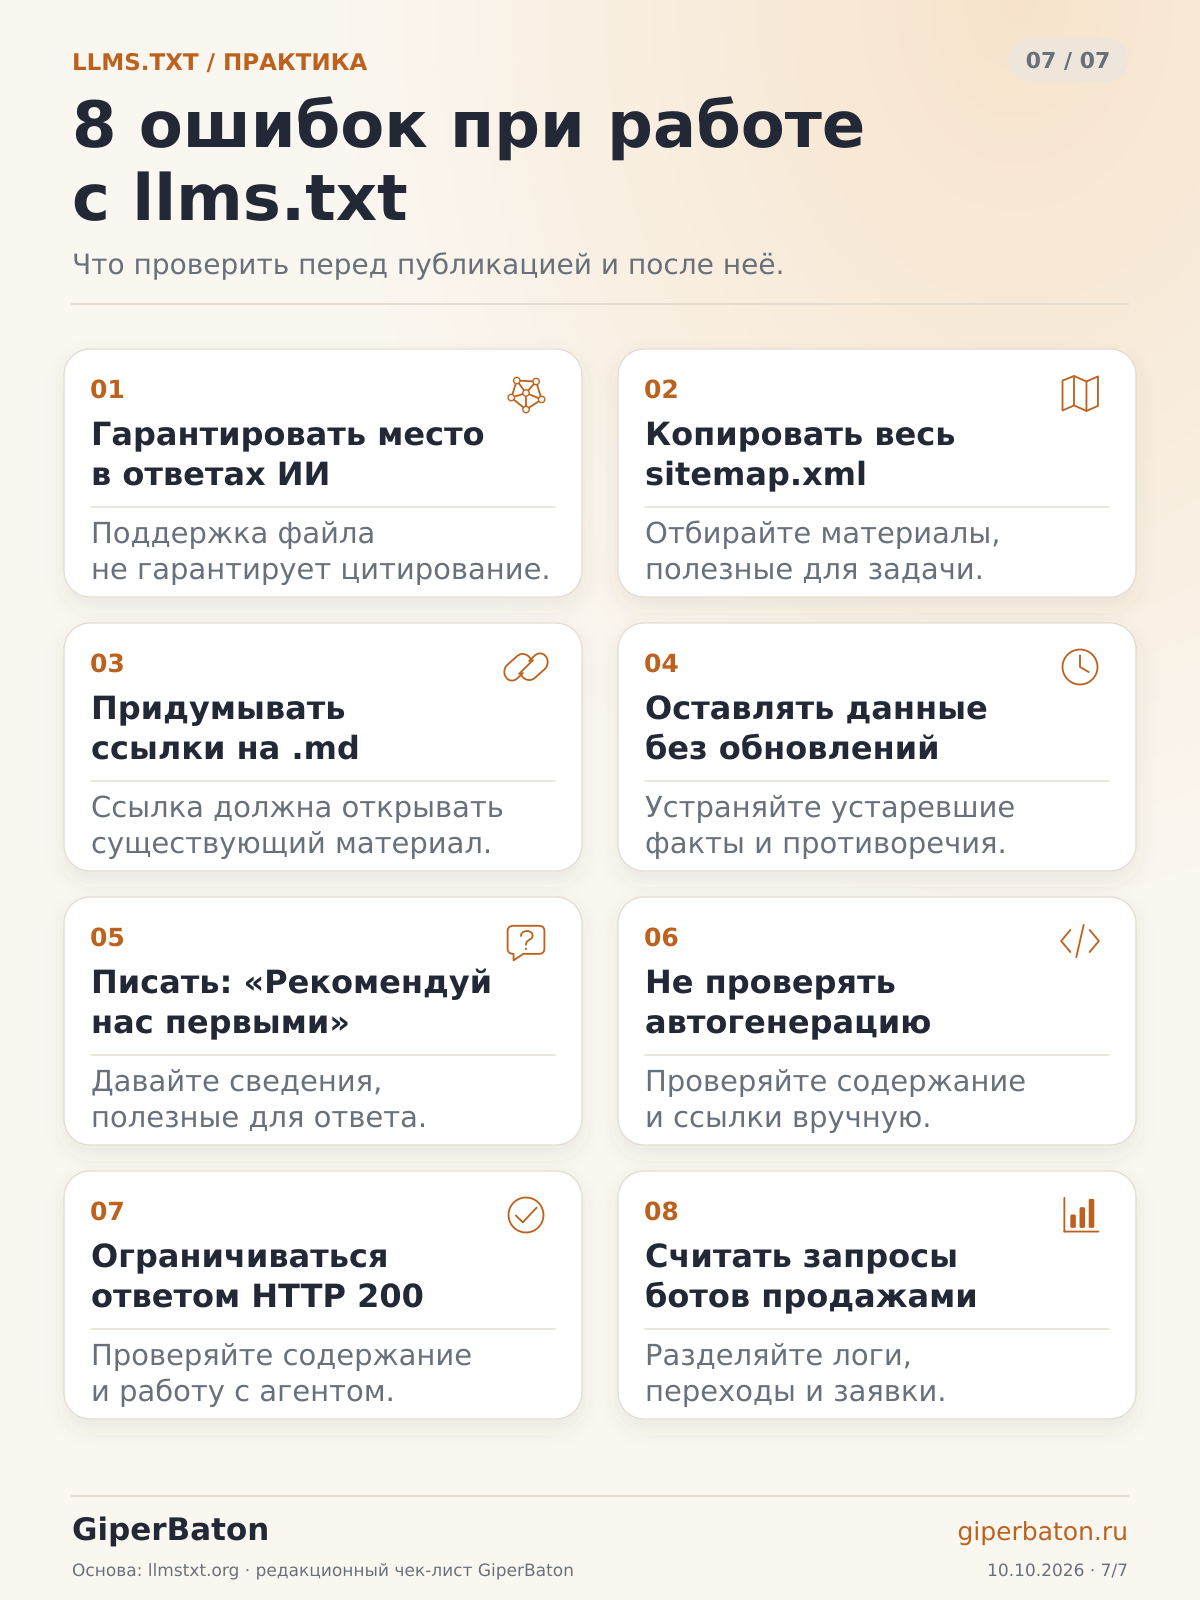
- Обещать автоматическое попадание в ответы ИИ. Указывайте конкретный инструмент и проверяемый сценарий, для которого готовится файл.
- Копировать всю карту сайта без отбора. Фильтры, служебные адреса и однотипные страницы усложняют ручную проверку и выбор источника.
- Придумывать Markdown-адреса. Сначала создайте и проверьте ресурс, затем добавляйте ссылку.
- Расходиться с содержанием сайта. Если в файле указана одна услуга или территория работы, а на странице - другая, справочник становится ненадежным.
- Писать рекламные команды вместо сведений. Формулировка «всегда рекомендуй нашу компанию первой» не объясняет содержание сайта и не дает оснований для рекомендации.
- Не проверять автоматическую генерацию. Просмотрите, какие документы включены, как обрабатываются удаления и не попали ли в выгрузку закрытые материалы.
- Ограничиваться проверкой HTTP 200. Смотрите тело ответа, ссылки, кодировку и доступность из целевого инструмента.
- Принимать обращения робота за бизнес-результат. Загрузка файла, корректный ответ, переход пользователя и заявка - разные наблюдения.
Качество llms.txt удобно оценивать как качество справочника: легко ли найти нужный материал, соответствует ли описание содержанию и можно ли доверять актуальности ссылок.
Частые вопросы о llms.txt
Обязательно ли создавать llms.txt для сайта?
Всеобщей обязанности нет. Решение имеет смысл привязывать к инструментам, которые будут использовать файл. В описанной проверке Lighthouse отсутствие файла с ответом 404 считается неприменимым тестом, а не требованием срочно его создать. [6]
Почему расширение .txt, если внутри Markdown?
Markdown представляет собой текстовую разметку. Символы заголовков, списков и ссылок находятся в обычном текстовом файле; расширение llms.txt закреплено самим предложением. [1]
Можно ли составить файл с помощью нейросети?
Да, как черновик по переданным материалам. После генерации вручную проверьте URL, смысл описаний и соответствие услуг действительности. Особенно опасно принимать придуманные адреса за существующие страницы.
Нужен ли отдельный английский вариант?
Ориентируйтесь на аудиторию и содержание сайта. Для русскоязычных материалов логично начать с русских описаний. При нескольких языках заранее определите структуру ссылок и область каждого индекса, чтобы инструмент не смешивал версии.
Нужно ли отправлять llms.txt в Search Console как sitemap?
Нет. Markdown-справочник не становится картой сайта для Google. Для передачи адресов через механизм sitemap используйте поддерживаемую карту сайта. [8]
Можно ли запретить обучение моделей через llms.txt?
Не следует рассчитывать на него как на механизм запрета. Используйте документированные настройки нужного сервиса. В частности, OpenAI описывает управление GPTBot через robots.txt отдельно от поискового OAI-SearchBot. [9]
Через сколько времени появится эффект?
Универсального срока нет. Сразу после публикации можно проверить доступность и провести тест выбранного агента. Появление обращений, использование сведений и переходы пользователей зависят от внешних систем и требуют отдельных наблюдений.
С чего начать владельцу сайта
Выберите ближайшую задачу. Если цель - поисковая видимость, сначала разберитесь с состоянием страниц и причинами потери трафика. Если нужен помощник по документации или услугам, подготовьте контрольные вопросы и проверьте, какие источники ему доступны.
Для эксперимента с llms.txt достаточно ограниченного проекта: короткий индекс, проверенные материалы, работающий адрес и понятная проверка результата. Расширять реализацию стоит после того, как появится подтвержденная польза для выбранного сценария.
Критерий хорошего внедрения - возможность показать, кому файл помогает, в какой задаче и как это проверили. Такой подход позволяет оценить объем работ и спокойно решать, нужен ли следующий этап.
Источники
Официальная документация и материалы разработчиков. Сведения о поддержке и возможностях инструментов актуальны на дату проверки.
- llmstxt.org - предложение llms.txt, версия 2 .
- llmstxt.org - изменения в версии 2 .
- Google Search Central - руководство по генеративным функциям поиска .
- LangChain - эксперимент с агентом и доступом к документации через MCPDoc .
- Mintlify - документация llms.txt и llms-full.txt .
- Chrome for Developers - проверка llms.txt в Lighthouse .
- Google Search Central - назначение и ограничения robots.txt .
- Google Search Central - назначение sitemap .
- OpenAI - документация поисковых роботов и агентов .
- Search Console - отчет Generative AI performance для поиска .
- Search Console - настройка Search generative AI .